Temps de lecture : environ 34 minutes. Les formules sont toujours suivies de leur intuition : on peut les survoler sans perdre le fil. Le dépôt est en anglais, ses figures aussi.
Note de transparence. Ces travaux ont été menés à titre personnel, dans un but d’apprentissage, avec l’assistance d’une IA :
- pour le code, la relecture technique et méthodologique ;
- pour comprendre les outils et les méthodes mathématiques ;
- pour l’aide à la rédaction, la traduction et la correction du texte ;
- pour générer l’image de couverture de l’article.
Le choix du sujet, le protocole, la vérification des résultats et les conclusions sont les miens, et j’en assume les erreurs. Comment j’utilise l’IA
Cet article restitue ma veille active de la semaine 44 (octobre 2026). Je suis parti d’un plan de travail détaillé, avec ses scripts, ses chiffres et ses conclusions. J’ai d’abord rejoué chaque script tel quel : tous reproduisent leurs chiffres au chiffre près. Puis j’ai vérifié chaque lecture de ces chiffres. Plusieurs ne tiennent pas, et c’est ce qui m’a le plus appris. J’ai aussi relu les sources à la source (licences sur le Hub, corps des articles plutôt que leurs résumés) et j’ai confronté le tout à des données réelles, sous un protocole écrit avant les résultats. Tout est reproductible dans le dépôt W44_retraining_frequency.
En bref. Les principaux résultats, avec leur périmètre :
- Sur un banc simulé, un détecteur de ruptures parfait obtient un MASE de 1,37, contre 0,98 pour un réentraînement hebdomadaire fixe. L’écart vient surtout de la fenêtre sur laquelle le modèle est réajusté après la détection. Avec une fenêtre qui redémarre à la rupture et un réentraînement hebdomadaire en complément, la même détection fait mieux que le réentraînement continu, sur 5 graines sur 5, avec 1 % de ses refits.
- Réentraîner moins souvent réduit la fréquence des révisions publiées, mais augmente leur taille. Du continu au mensuel, le saut moyen est multiplié par 224 dans le modèle analytique.
- Le budget de fraîcheur dépend du quantile servi d’un facteur 2 en simulation, et non de 7 comme l’indiquait le plan. Sur données réelles, la règle de décision pré-enregistrée ne tranche pas.
- La latence de clôture des données modifie trois mesures : l’erreur du backtest (sous-estimée d’environ 6 %), la baseline et le déclencheur.
- Un tableau de bord avant/après affiche 197 % de l’effet réel avec un réentraînement qui ne fait rien, à cause de la régression vers la moyenne. Le seuil de déclenchement permet aussi d’estimer l’effet au seuil, par régression sur discontinuité.
1. Le problème : choisir une fréquence de réentraînement#
Un service de prévision publie, à chaque origine \(t_0\), des prévisions pour les \(H\) pas suivants. Le modèle qui les produit a été ajusté sur une fenêtre d’historique de longueur \(w\), à un certain moment. La question opérationnelle est : tous les combien de pas \(k\) faut-il le réajuster ? \(k = 1\), c’est le réentraînement continu ; en données horaires, \(k = 24\) est quotidien, \(k = 168\) hebdomadaire et \(k = 720\) mensuel.
On peut décrire ce qu’on attend du service selon trois axes :
| Axe | L’attente | Ce qu’elle implique pour la fréquence |
|---|---|---|
| Exactitude | l’erreur moyenne reste basse | réentraîner souvent (un modèle récent suit mieux le niveau) |
| Fraîcheur | le modèle servi n’a jamais plus de X heures | une borne sur \(k\), qui peut dépendre de ce qu’on sert |
| Stabilité | la prévision publiée ne change pas sans raison | dépend de la mesure retenue : taille ou fréquence des révisions |
À cela s’ajoute le coût : chaque refit consomme du calcul, ce qui compte sur un parc de centaines de milliers de séries.
Un dernier paramètre intervient tout au long de l’article : la latence de clôture \(d\). Une donnée n’est pas utilisable dès qu’elle existe. Une consommation électrique, une vente, une facture sont consolidées, corrigées, validées, puis seulement disponibles. Ici, \(d = 48\) heures : un modèle « réentraîné maintenant », à l’instant \(t\), est ajusté sur une fenêtre qui se termine à \(t - 48\).
| Notation | Sens | Valeur dans le banc |
|---|---|---|
| \(k\) | cadence : pas entre deux refits | de 1 à 720 heures |
| \(w\) | longueur de la fenêtre d’ajustement | 240 heures |
| \(d\) | latence de clôture des données | 48 heures |
| \(H\) | horizon de prévision | 24 heures |
| \(\tau\) | niveau de quantile servi | 0,50 · 0,80 · 0,95 |
Ce paramètre \(d\) intervient à trois endroits de l’analyse : le backtest, la baseline et le déclencheur.
2. Ce que disent les travaux récents#
J’ai lu cinq travaux récents et j’en ai écarté un. Pour chacun, je suis allé chercher les chiffres dans le corps de l’article, pas dans le résumé, qui n’en contient parfois aucun.
Les deux articles de Marco Zanotti posent le cadre. Le premier (arXiv 2505.00356) étudie dix modèles globaux sur les données de distribution M5 et VN1, du réentraînement continu à l’absence de réentraînement. Le second (arXiv 2506.05776) introduit une mesure de stabilité des prévisions probabilistes, le Scaled Multi-Quantile Change (SMQC). Ce qu’on trouve dans les corps des articles :
- en prévision ponctuelle, ne jamais réentraîner dégrade l’erreur de moins de 5 % sur ces jeux ; un réentraînement mensuel réduit le temps de calcul d’environ 75 % ;
- la prévision probabiliste est plus sensible : la fréquence optimale est d’environ 2 semaines sur M5 contre 3 à 4 semaines pour la prévision ponctuelle ;
- la stabilité ne suit pas une règle simple : sur VN1, réentraîner moins souvent rend NBEATSx et CatBoost plus stables, mais rend le MLP et la régression linéaire moins stables. Sur M5, presque rien ne bouge.
La prévision probabiliste semble donc demander des réentraînements un peu plus fréquents que la prévision ponctuelle, avec un effet modéré. Ce point revient en partie 6.
Harrison Katz (arXiv 2604.06438) traite le réentraînement comme une décision coûteuse. Il surveille une « dette d’apprentissage » : la divergence de Kullback-Leibler entre une postérieure fantôme, mise à jour en continu, et la postérieure gelée du modèle déployé. On réentraîne quand le regret attendu de l’attente dépasse le coût du refit. Sa politique fait mieux qu’un calendrier réglé dans 72 cellules de scénario sur 72, et mieux qu’un CUSUM réglé dans 58 sur 72, avec un objectif relatif moyen de 0,975 face au CUSUM. L’écart avec un CUSUM bien réglé est donc faible ; l’apport principal est un seuil exprimé en unités de coût. L’article se présente d’ailleurs comme une « preuve de concept » sur simulation, « pas un remplacement universel de la détection de dérive ».
PILOT (Kwak, Jung, Park, arXiv 2609.39789) apprend un déclencheur de réentraînement. Le résumé ne donne aucun chiffre de gain. J’en ai retenu un choix de conception : l’étiquette d’entraînement du déclencheur est une quantité future (la hausse d’erreur à venir), alors que le déclencheur déployé ne lit que des erreurs déjà closes. Cette séparation évite que le déclencheur utilise des données indisponibles au moment de décider. La partie 4 montre l’effet de ce type de fuite sur un CUSUM.
Timestral (Mistral, 15 octobre 2026) est une famille de foundation models de séries temporelles (5M, 28M, 123M et 209M paramètres) qui tourne sur CPU, à 140 ms pour le plus gros sur 8 threads. Elle concerne surtout la mise en service des modèles ; j’y reviens en partie 8, notamment pour sa licence.
Écarté : DriftGuard (arXiv 2601.08928). Il annonce « 97,8 % de rappel de détection en 4,2 jours » et un « retour sur investissement allant jusqu’à 417 », sans unité. Faute d’unité, je n’ai pas pu interpréter ce second chiffre, et je n’ai pas retenu l’article comme source.
3. Le banc d’essai#
Pour comparer des politiques de réentraînement, il faut un terrain où l’on connaît la vérité. J’ai donc simulé un parc de 120 séries horaires sur 2 400 pas, servies à horizon 24 par un modèle volontairement simple : la moyenne de la fenêtre, plus un profil journalier sur 24 heures, ajustés sur \(w = 240\) heures.
Les séries subissent deux dérives de nature différente :
- des ruptures de niveau brutales, tirées selon un processus de Poisson (3,7 par série en moyenne, 448 au total) ;
- une dérive lente de l’amplitude saisonnière, sinusoïdale.
Dix politiques sont comparées : jamais ; un calendrier à \(k \in \{1, 24, 48, 168, 720\}\) ; un CUSUM bilatéral sur l’erreur réalisée ; la dette KL de Katz à deux seuils ; et un détecteur parfait, qui connaît la date exacte de chaque rupture et réentraîne dessus. On mesure l’exactitude (MASE), le coût (refits par série) et la stabilité (partie 5).
| Politique | MASE | Refits / série |
|---|---|---|
| jamais | 1,6003 | 0 |
| calendrier mensuel (\(k = 720\)) | 1,2520 | 2 |
| calendrier hebdomadaire (\(k = 168\)) | 0,9829 | 12 |
| calendrier quotidien (\(k = 24\)) | 0,9042 | 85 |
| continu (\(k = 1\)) | 0,8915 | 2 063 |
| CUSUM sur l’erreur réalisée | 0,9189 | 92,5 |
| dette KL (seuil 2) | 0,9546 | 30,3 |
| détecteur parfait | 1,3685 | 3,7 |
Effet de la latence de clôture sur le backtest#
Première vérification : que se passe-t-il si le backtest ignore \(d\), c’est-à-dire s’il ajuste le modèle sur des données qui, en production, ne seraient pas encore closes ?
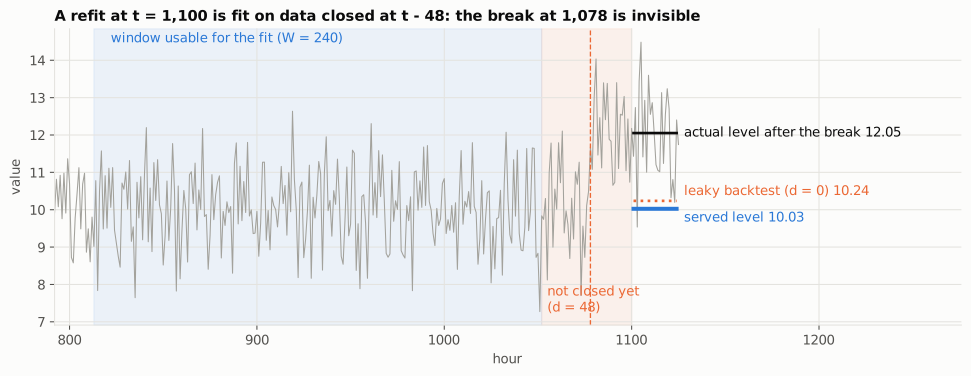
Sans la latence, le MASE est sous-estimé d’environ 6 % pour toutes les politiques : +6,3 % en quotidien, +5,6 % en hebdomadaire, +6,2 % pour CUSUM. Comme l’écart est à peu près le même partout, le classement des politiques ne change pas : toute la courbe se décale. Un écart uniforme est difficile à repérer, puisqu’il ne modifie pas les comparaisons. Il modifie en revanche le niveau d’erreur annoncé.
4. Le cas du détecteur de ruptures parfait#
Ce résultat m’a surpris. Un détecteur qui connaît toutes les ruptures, sans fausse alarme ni retard, et qui réentraîne 3,7 fois par série au moment de chaque rupture, obtient un MASE de 1,3685. Un réentraînement hebdomadaire fixe obtient 0,9829. Le détecteur parfait arrive avant-dernier, devant la seule politique qui ne réentraîne jamais.
Le plan de travail proposait une explication : la dérive saisonnière lente n’est pas une rupture, donc un détecteur de ruptures ne la corrige pas. J’ai testé cette explication ; les vérifications ci-dessous montrent qu’elle ne rend compte que d’une petite partie de l’écart.
Trois vérifications#
(a) Sans dérive saisonnière, l’écart demeure. Avec les seules ruptures de niveau (mêmes ruptures, plus de dérive lente), l’hebdomadaire obtient 0,9425 et le détecteur parfait 1,2620. Il ne reste qu’un type de dérive, celui que le détecteur repère sans erreur, et l’écart est encore de 34 %.
(b) La fenêtre de réajustement ne contient pas la rupture. Le détecteur se déclenche à l’instant \(t\) de la rupture. Mais à cause de \(d\), la fenêtre d’ajustement se termine à \(t - 48\) : elle ne contient aucun point postérieur à la rupture. Le refit est ajusté sur l’ancien régime. Retarder le refit améliore le score, lentement :
| Retard du refit après la rupture | 0 | 48 | 120 | 168 | 288 (\(= d + w\)) |
|---|---|---|---|---|---|
| MASE | 1,3685 | 1,3699 | 1,2071 | 1,1384 | 1,1110 |
48 heures après la rupture, la fenêtre ne contient encore qu’un point postérieur sur 240. Une moyenne sur 240 pas en est à peine modifiée.
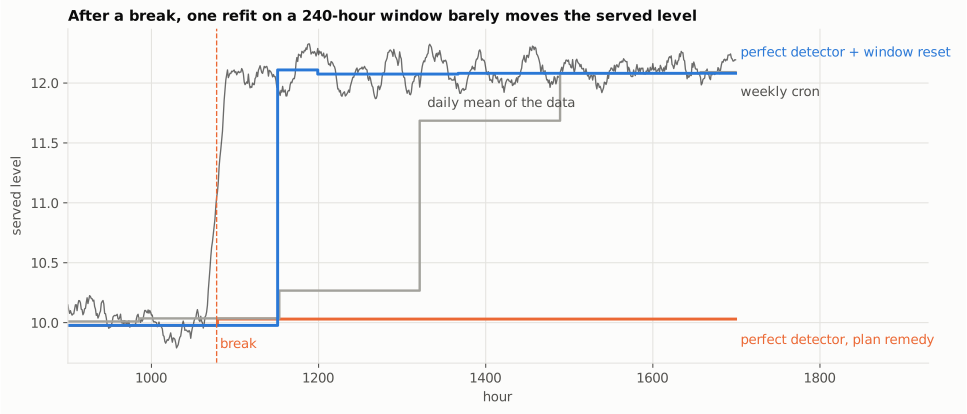
(c) Changer ce qui suit la détection. J’ai gardé la même détection et changé le réajustement : après une rupture en \(c\), réajuster en \(c + d + 24\), \(c + d + 72\) et \(c + d + 240\), sur une fenêtre qui commence à la rupture au lieu de couvrir l’ancien régime.
| Politique | MASE | Refits / série |
|---|---|---|
| hebdomadaire | 0,9829 | 12,0 |
| continu | 0,8915 | 2 063 |
| détecteur parfait, réajustement du plan | 1,3685 | 3,7 |
| détecteur parfait + fenêtre redémarrée | 0,9489 | 10,2 |
| détecteur parfait + fenêtre redémarrée + hebdomadaire | 0,8789 | 22,2 |
La dernière ligne fait mieux que le réentraînement continu, avec 1 % de ses refits. Comme il s’agit d’un seul tirage, j’ai rejoué l’expérience sur cinq graines et comparé les politiques par graine (chacune voit les mêmes séries) :
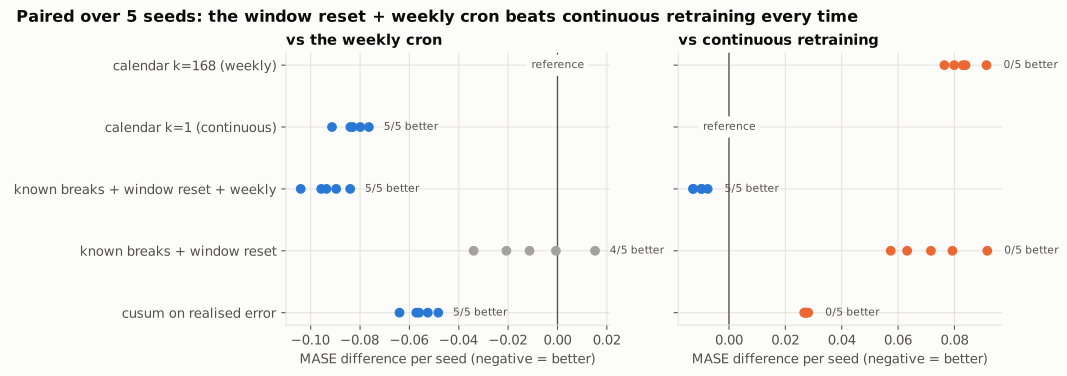
Sur ce banc, ce n’est donc pas la détection qui pose problème, mais ce qui la suit. Deux choix interviennent : quand réajuster, et sur quelle fenêtre. Avec une fenêtre fixe, la détection apporte peu. Seule, elle ne traite pas la dérive lente. Combinée à une fenêtre qui redémarre à la rupture et à un réentraînement hebdomadaire, elle donne le meilleur score du banc.
Le CUSUM et les erreurs non closes#
Dans le plan, le CUSUM se distinguait par son ciblage : 40,9 % de ses refits tombaient moins de 72 heures après une rupture, contre 12,2 % pour un calendrier, soit 3,4 fois plus. Mais ce CUSUM lisait l’erreur de la prévision pour \(t\) à l’instant \(t\), alors que le banc suppose que les observations ne sont closes qu’à \(t + 48\). Le déclencheur utilisait donc des données que le modèle, lui, ne pouvait pas utiliser.
Avec des erreurs closes au même délai, le MASE change à peine (0,9179 contre 0,9189), mais le ciblage tombe à 20,0 % : 1,6 fois le calendrier, et non 3,4. Environ la moitié de l’avantage venait de cette fuite. C’est la séparation que fait PILOT : le déclencheur déployé ne lit que des erreurs closes.
L’indicateur lui-même mérite une remarque. « Part des refits à moins de 72 heures d’une rupture » compte aussi des refits qui ne peuvent rien corriger : avec \(d = 48\), un refit moins de 48 heures après une rupture ne la voit pas. C’est en partie pour cela que le détecteur parfait atteint 100 % sur cet indicateur tout en ayant l’un des moins bons MASE. Sur ce banc, le rappel de détection ne renseigne donc pas sur la précision obtenue.
5. La stabilité des prévisions publiées#
Quand un utilisateur consulte la prévision de demain le lundi, puis le mardi, il s’attend à ce qu’elle ne change que si quelque chose a changé. Chaque refit révise la prévision publiée. On appelle churn l’ampleur moyenne de ces révisions par pas de temps.
On pourrait penser que réentraîner moins souvent rend le service plus stable. C’est vrai pour la fréquence des révisions, pas pour leur taille.
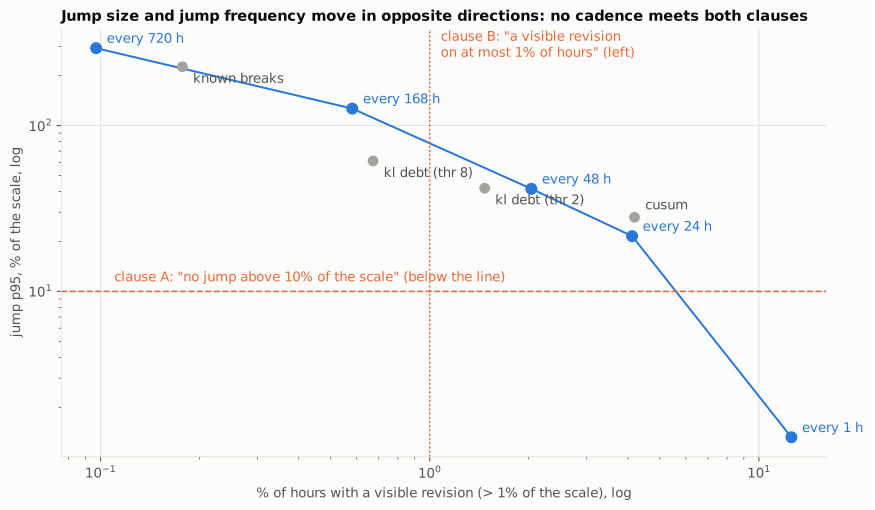
Le réentraînement mensuel publie des sauts dont le 95e percentile vaut 293 % de l’échelle, sur 0,1 % des origines. Le continu publie des sauts de 1,3 %, sur 12,6 % des origines. Les deux manières habituelles d’exprimer une exigence de stabilité, « aucune révision supérieure à X % » et « au plus N révisions par mois », classent les politiques dans des ordres opposés. Sur ce banc, aucune cadence ne satisfait les deux à la fois.
Le churn moyen, souvent suivi, a une limite : il vaut exactement zéro pour un modèle jamais réentraîné. Il ne distingue donc pas un modèle stable d’un modèle figé.
Un modèle analytique : le niveau local#
Pour comprendre d’où vient cette opposition, j’ai pris le modèle le plus simple possible, où tout se calcule à la main : un niveau local. La série vaut un niveau qui suit une marche aléatoire, plus du bruit :
$$ y_t = L_t + \varepsilon_t, \qquad L_t = L_{t-1} + u_t, \qquad u_t \sim \mathcal N(0, q), \quad \varepsilon_t \sim \mathcal N(0, \sigma^2). $$Le service publie la moyenne des \(w\) dernières observations, réestimée tous les \(k\) pas. Le modèle servi a un âge moyen \(\bar a = (k-1)/2\). Son erreur quadratique moyenne se décompose exactement :
$$ \text{MSE}(k, w) = \underbrace{\sigma^2\left(1 + \tfrac{1}{w}\right)}_{\text{bruit}} + q\Big[\underbrace{(\bar a + 1)}_{\text{âge du modèle}} + \underbrace{\tfrac{(w-1)(2w-1)}{6w}}_{\text{retard de la fenêtre}}\Big]. $$Le dernier terme est le retard du centroïde : une moyenne sur \(w\) pas estime le niveau tel qu’il était \((w-1)/2\) pas plus tôt, et non le niveau actuel. Annuler la dérivée en \(w\) donne la fenêtre optimale :
$$ w^\star = \sqrt{\frac{3\,(\sigma^2 + q/6)}{q}} \approx 27{,}4 \quad (\sigma = 1,\ q = 0{,}004). $$L’intuition. Les deux paramètres agissent sur deux termes additifs. La fenêtre détermine son propre retard, la cadence détermine l’âge du modèle. Réentraîner plus souvent ne réduit pas le retard dû à une fenêtre trop longue. Le cas d’une tendance l’illustre : sur \(y_t = 0{,}01\,t + \text{bruit}\) avec \(w = 240\), passer du mensuel au continu supprime 75 % du biais. Les 25 % restants viennent entièrement de la fenêtre, et aucune cadence ne les réduit. Ce biais relève de la spécification du modèle (terme de tendance, pondération) plutôt que de la fréquence de réentraînement.
Pour la stabilité, la variance du saut \(R\) entre deux réestimations espacées de \(k\) pas (avec \(a = \min(k, w)\) et \(b = \max(k, w)\)) se décompose en deux termes :
$$ \operatorname{Var}(R) = \underbrace{\frac{2a\,\sigma^2}{w^2}}_{\text{fluctuation d'estimation}} + \underbrace{\frac{q}{w^2}\left[a^2(b - a + 1) + \frac{(a-1)\,a\,(2a-1)}{3}\right]}_{\text{mouvement réel du niveau}}. $$Le premier terme correspond au bruit : la fenêtre a glissé, quelques observations bruitées sont entrées et sorties, et la prévision bouge sans que le niveau ait changé. Le second correspond à l’information : le niveau a réellement bougé. La part de bruit est le rapport du premier terme à la variance totale, c’est-à-dire la part des révisions publiées qui ne reflète pas un changement du niveau.
J’ai confronté ces formules à une simulation de Monte-Carlo de 300 000 pas sur huit configurations : le MSE concorde à 0,6 % près, la variance des sauts à 1,8 % près, un écart inférieur à l’erreur de Monte-Carlo elle-même mesurée sur cinq graines.
| Cadence \(k\) | Saut moyen | Churn par pas | Saut vs \(k = 1\) | Churn vs \(k = 1\) | Part de bruit |
|---|---|---|---|---|---|
| 1 | 0,0057 | 0,00572 | ×1 | ×1 | 67,6 % |
| 24 | 0,0802 | 0,00334 | ×14 | ×0,58 | 8,2 % |
| 168 | 0,4830 | 0,00288 | ×84 | ×0,50 | 1,6 % |
| 720 | 1,2787 | 0,00178 | ×224 | ×0,31 | 0,3 % |
Du continu au mensuel, le saut publié est multiplié par 224 alors que le churn par pas n’est divisé que par 3,2. Dans ce modèle, réentraîner moins souvent réduit peu l’instabilité totale : elle est publiée moins souvent, mais par sauts plus grands.
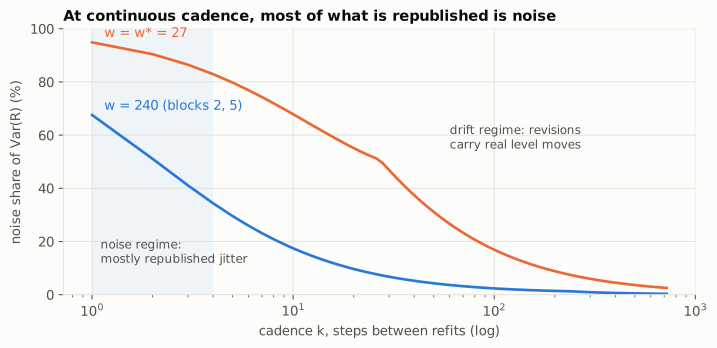
À cadence continue sur une fenêtre de 240 pas, deux tiers de la variance des révisions viennent du bruit d’estimation. Avec la fenêtre optimale \(w^\star = 27\), c’est 95 %. Plus la fenêtre est courte, plus cette part est élevée. Autrement dit, à cadence continue, la plupart des révisions publiées reflètent la fluctuation de l’estimation plutôt qu’un changement du niveau.
6. Fraîcheur du modèle et quantile servi#
Un service probabiliste ne publie pas une valeur mais des quantiles : la médiane (\(\tau = 0{,}50\)) pour planifier, le quantile 0,95 pour dimensionner un stock ou une capacité. Chacun s’évalue avec la perte pinball :
$$ \rho_\tau(y, \hat q) = \begin{cases} \tau\,(y - \hat q) & \text{si } y \ge \hat q,\\ (1 - \tau)\,(\hat q - y) & \text{sinon.}\end{cases} $$L’intuition. Au quantile 0,95, une prévision trop basse coûte 19 fois plus qu’une prévision trop haute du même écart. La perte est minimale quand 95 % des observations tombent sous la prévision.
La question de cette partie : à partir de quel âge un modèle cesse-t-il de faire mieux qu’une baseline naïve ? J’appelle \(k_{\max}\) la plus grande cadence à laquelle le modèle fait encore mieux que la naïve saisonnière (« demain sera comme aujourd’hui à la même heure »). C’est le budget de fraîcheur qu’on pourrait inscrire dans un contrat de service.
Le résultat de départ#
Sur 200 séries simulées, avec des quantiles gaussiens (moyenne plus \(z_\tau\) fois l’écart-type des résidus dans la fenêtre), le plan obtenait :
| \(\tau = 0{,}50\) | \(\tau = 0{,}80\) | \(\tau = 0{,}95\) | |
|---|---|---|---|
| \(k_{\max}\) | 168 h | 120 h | 24 h |
| dégradation de \(k = 1\) à \(k = 720\) | +41 % | +52 % | +97 % |
Le quantile 0,95 demanderait donc un modèle sept fois plus récent que la médiane, ce qui plaiderait pour un budget de fraîcheur propre à chaque quantile. En vérifiant ce résultat, j’ai trouvé deux effets qui l’expliquent en grande partie.
La couverture des quantiles gaussiens#
Un quantile 0,95 bien calibré est dépassé 5 % du temps. Celui-ci couvre 90,9 % des observations quand le modèle est récent, et 83,5 % quand il a un mois.
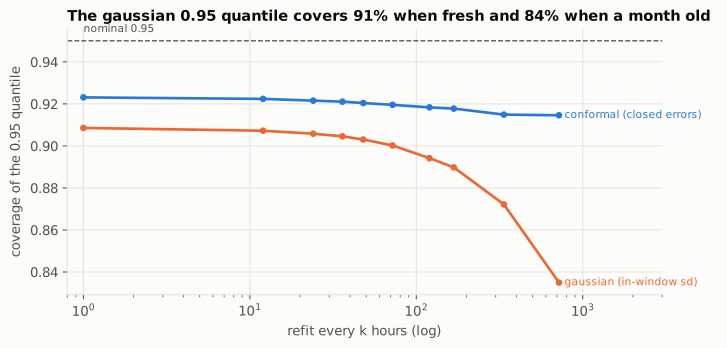
L’écart-type est mesuré dans la fenêtre, sur des résidus in-sample. Il ne tient pas compte de ce que l’erreur hors échantillon augmente avec l’âge du modèle. Les « +97 % au quantile 0,95 » reflètent donc surtout un défaut de calibration, plus qu’un coût de fraîcheur.
Une alternative : placer les quantiles au quantile empirique des erreurs closes du modèle lui-même, par série et par horizon, sur les 240 dernières origines, recalculé toutes les 24 heures. C’est une forme de prédiction conforme. La dégradation de \(k = 1\) à \(k = 720\) devient alors +19 %, +19 % et +21 % pour les trois quantiles, presque la même. La couverture au quantile 0,95 reste entre 0,915 et 0,923 à toutes les cadences. Elle n’atteint pas 0,95 : la garantie conforme suppose des erreurs échangeables, ce que les ruptures de niveau ne respectent pas.
Les données lues par la baseline#
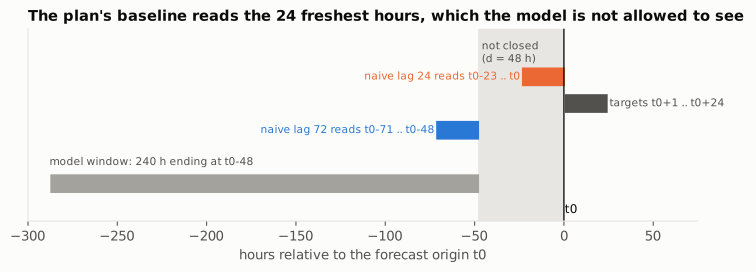
À l’origine \(t_0\), la naïve saisonnière du plan copie \(y_{t_0-23}, \dots, y_{t_0}\). Le modèle, lui, n’a accès qu’aux données closes à \(t_0 - 48\). La comparaison donne à la baseline 48 heures de données auxquelles le modèle n’a pas accès. La baseline comparable, sous \(d = 48\), est la naïve à 72 heures (la même heure, trois jours plus tôt), et elle est nettement moins bonne.
C’est la situation inverse du backtest de la partie 3 : ici, ignorer la latence avantage la baseline.
Résultats après correction#
| Quantiles | Baseline | \(k_{\max}\) 0,50 | 0,80 | 0,95 | Rapport 0,50 / 0,95 |
|---|---|---|---|---|---|
| gaussiens | naïve 24 h (plan) | 168 | 120 | 24 | 7,0 |
| gaussiens | naïve close | 168 | 168 | 72 | 2,3 |
| conformes | naïve 24 h (plan) | 168 | 168 | 36 | 4,7 |
| conformes | naïve close | 336 | 336 | 168 | 2,0 |
Avec les deux corrections, le budget de fraîcheur dépend toujours du quantile servi, mais d’un facteur 2, stable sur cinq graines. Ce résultat va dans le même sens et a le même ordre de grandeur que ceux de Zanotti : la prévision probabiliste demande des réentraînements un peu plus fréquents que la prévision ponctuelle (2 semaines contre 3 à 4 sur M5), et non sept fois plus.
La stabilité dépend aussi de la méthode de calcul des quantiles. Avec des quantiles gaussiens, seul le réentraînement continu respecte « saut p95 ≤ 10 % » au quantile 0,95. Avec des quantiles conformes, toutes les cadences le respectent (de 2,9 % à 8,4 %), mais la recalibration publie une révision visible sur 19 % à 45 % des origines. On retrouve l’opposition entre taille et fréquence des révisions de la partie 5.
7. Données réelles : Monash Electricity#
Les résultats précédents viennent de données simulées. Pour les confronter à des données réelles, j’ai repris l’analyse sur Monash Electricity Hourly : 321 séries de consommation électrique horaire, de 2012 à 2014, sous licence CC-BY-4.0.
Le protocole#
Avant de lancer le moindre calcul, j’ai écrit et commité un protocole : les séries retenues, la période d’évaluation, les baselines, les métriques et la règle de décision. Sept séries ont été exclues pour plus de 10 % de zéros (dont une entièrement nulle). Restent 314 séries et 8 760 origines horaires sur 2014, avec une perte pinball normalisée série par série.
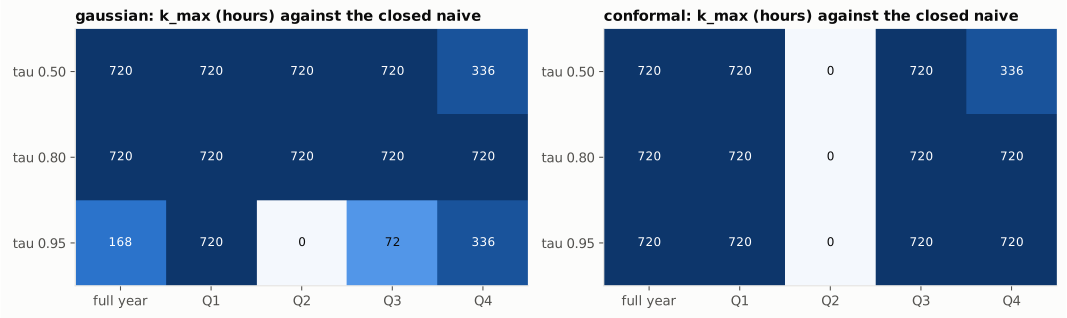
La règle de décision pré-enregistrée : avec des quantiles conformes, comparer \(k_{\max}\) entre la médiane et le quantile 0,95 contre la naïve à 24 heures. L’hypothèse du plan (le budget de fraîcheur dépend du quantile) est confirmée si le rapport vaut au moins 4 sur l’année et dans au moins 3 trimestres sur 4, contredite s’il vaut 1 ou moins sur l’année.
Comparaison aux baselines#
| \(\tau = 0{,}50\) | \(\tau = 0{,}80\) | \(\tau = 0{,}95\) | couverture 0,95 | |
|---|---|---|---|---|
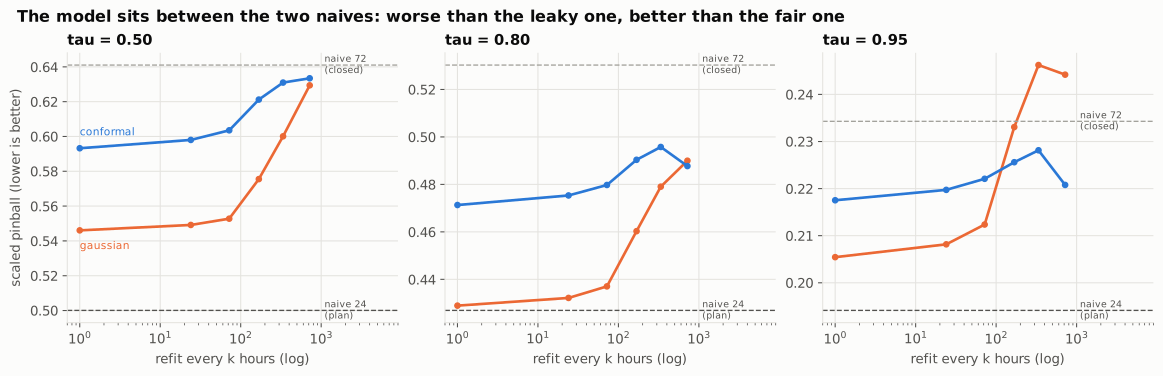
| naïve 24 h (lit des données non closes) | 0,5001 | 0,4269 | 0,1941 | 0,945 |
| naïve 72 h (close) | 0,6410 | 0,5303 | 0,2343 | 0,938 |
| naïve 168 h (close, hebdomadaire) | 0,5586 | 0,4654 | 0,2190 | 0,932 |
| modèle gaussien, \(k = 1\) | 0,5461 | 0,4289 | 0,2054 | 0,909 |
| modèle gaussien, \(k = 720\) | 0,6294 | 0,4900 | 0,2442 | 0,895 |
| modèle conforme, \(k = 1\) | 0,5932 | 0,4713 | 0,2175 | 0,909 |
| modèle conforme, \(k = 720\) | 0,6334 | 0,4877 | 0,2208 | 0,909 |
Application de la règle de décision#
Appliquée telle qu’écrite, la règle pré-enregistrée ne tranche pas. Contre la naïve à 24 heures, le modèle ne fait jamais mieux à la médiane, à aucune cadence et à aucun trimestre : \(k_{\max} = 0\) et le rapport n’est pas défini. L’hypothèse n’est ni confirmée, ni contredite.
J’ai ajouté après coup la comparaison à la naïve close, parce que la partie 6 a montré que la naïve à 24 heures lit des données non closes. C’est un écart au protocole, et je le présente comme tel. Contre cette baseline, avec des quantiles conformes, le modèle reste meilleur jusqu’à 720 heures à tous les quantiles : le rapport vaut 1,0 et l’hypothèse est contredite. Je rapporte les deux résultats ; seul le premier correspond au protocole pré-enregistré.
Ce que montrent ces données :
- Contre une baseline qui lit les données les plus récentes, aucune cadence ne fait mieux. Sur cette consommation électrique, la naïve à 24 heures est assez forte pour que ses 48 heures de données supplémentaires suffisent à dépasser le modèle, quelle que soit la cadence. Ignorer la latence pour la baseline fait conclure que le modèle n’apporte rien ; l’ignorer pour le modèle le fait paraître meilleur qu’il n’est (+12,8 % au quantile 0,95, en quotidien).
- Contre la baseline close, la dépendance au quantile est faible avec des quantiles calibrés, et instable sans. En gaussien, j’ai obtenu 720 / 720 / 168, puis 336 / 336 / 168 en décalant simplement le calendrier des refits de 240 heures. Une valeur qui varie d’un facteur 2 avec ce seul décalage me paraît trop fragile pour servir de seuil contractuel.
- Le deuxième trimestre fait exception. D’avril à juin 2014, le modèle est moins bon que la naïve close à toutes les cadences en conforme. Un budget de fraîcheur unique, mesuré sur l’année, masque cette variation.
- Aucune des deux méthodes n’est calibrée : environ 91 % de couverture pour un quantile 0,95, à toutes les cadences. Le conforme garde une couverture stable quand le modèle vieillit, mais pas à son niveau nominal : sur une année de consommation, les erreurs ne sont pas échangeables.
- Le cycle hebdomadaire compte pour un sixième des séries. La semaine moyenne de la série médiane est plate, mais 52 séries (17 %) ont des week-ends au moins 10 % plus bas. Sur ces séries, la naïve hebdomadaire fait nettement mieux que la naïve à 72 heures. Le modèle, avec son profil sur 24 heures, ne capte pas non plus ce cycle. Pour ces séries, ajouter un profil hebdomadaire serait probablement plus utile que de changer la cadence.
8. Le service de prévision en production#
Les parties précédentes portent sur le modèle. Celle-ci porte sur le système qui le sert.
L’Open Inference Protocol et la dimension temporelle#
Le protocole d’inférence standard de l’écosystème, l’Open Inference Protocol V2 (KServe,
Seldon, MLServer, Triton), décrit des requêtes et des réponses faites de tenseurs. Je l’ai relu
champ par champ : il n’a aucun champ pour le temps. Pas d’as_of, pas d’horizon, pas de niveaux
de quantile. Il y a un model_version, mais ni date d’entraînement ni version des variables. Le
seul point d’extension, parameters, est décrit ainsi par la spécification : « Currently no
parameters are defined ». Ce qu’on y met dépend donc du serveur.
Conséquence pratique : deux requêtes identiques envoyées à deux dates différentes sont la même
requête pour le protocole. Un cache dont la clé est (série, horizon) renvoie la même prévision un
mois plus tard, et après un réentraînement. En écrivant le test correspondant, j’ai d’ailleurs
constaté que ma propre clé de cache, dans le contrat, omettait la date d’entraînement. Avec une clé
trop large, le cache peut continuer à servir une prévision ancienne sans que rien ne le signale, ce
qui peut masquer, par exemple, un réentraînement qui n’a pas eu lieu.
Une solution est de placer cette information au-dessus du protocole, dans une passerelle de
prévision qui ajoute as_of, horizon, quantiles, date d’entraînement et versions, et qui construit
la clé de cache avec l’ensemble. La même passerelle peut refuser de servir un modèle plus ancien que
le budget de fraîcheur du quantile demandé, et revenir alors à la naïve close.
Côté outillage, deux constats en vérifiant l’installation sur Python 3.13. mlserver,
l’implémentation de référence du protocole, n’a pas publié de version stable depuis juin 2025 et
déclare Requires-Python <3.13. Pourtant, pip install mlserver n’échoue pas : il installe
sans avertissement la version 1.3.5, de juillet 2023, la dernière sans borne déclarée. Et uv
installe la 1.7.1 sans tenir compte de la borne supérieure. Dans les deux cas, aucun message ne
signale le problème ; il est donc utile de vérifier la version effectivement installée et les bornes
déclarées, pas seulement le succès de l’installation. KServe, maintenu, implémente le même
protocole.
Coût de service d’un foundation model sur CPU#
Timestral rend envisageable un foundation model servi sur CPU. D’après les latences publiées, rafraîchir 500 000 séries par jour avec le 209M consomme 163 € de CPU par mois. Mais s’il faut tout recalculer dans une fenêtre nocturne de 30 minutes, il faut 39 machines à 8 vCPU, qui coûtent 7 862 € par mois si elles restent allouées.
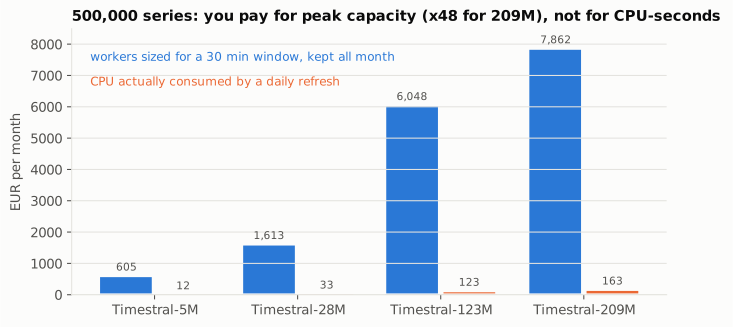
Soit un facteur 48. Le coût dépend alors de la fenêtre de calcul plus que de la cadence, sauf si la plateforme peut libérer les machines entre deux fenêtres. Et à 1 € de perte de décision par série et par mois, avec un refit toutes les 6 heures, un TSFM n’a besoin de faire mieux que le modèle classique que de 0,13 % pour couvrir son coût de calcul. Dans ce scénario, le calcul pèse peu ; l’exactitude sur les données concernées et la licence pèsent davantage.
La licence des poids de Timestral#
Le code de Timestral est sous Apache-2.0, mais pas les poids. Le fichier LICENSE des quatre dépôts
du Hub est une « Modified MIT License » qui contient une clause importante : aucun droit
d’utilisation si le chiffre d’affaires mensuel consolidé de l’entreprise, ou de l’employeur de
l’utilisateur, dépasse 20 millions de dollars, dérivés et fine-tunes compris. Pour un consultant,
c’est donc le chiffre d’affaires du client qui compte. Les poids de Chronos-2, eux, sont bien sous
Apache-2.0 : cette restriction est propre à Timestral.
La licence des poids se trouve donc sur le Hub, pas sur le badge du dépôt de code, et son application dépend du client.
Un contrat de service vérifiable#
J’ai regroupé ces éléments dans un fichier de contrat, forecast_service.yaml, vérifié par une
porte de déploiement déterministe avant toute mise en production. Six règles : la licence est
valide pour ce client, la fenêtre de calcul est tenable, la cadence respecte le budget de
fraîcheur de chaque quantile, une seule exigence de stabilité est retenue, l’effet du
réentraînement est mesurable, et la latence de clôture s’applique au backtest, à la baseline et
au déclencheur.
PASS  G1 weights licence     ALLOW under the cap (Modified MIT), re-check monthly
PASS  G2 compute window      1 workers needed, 2 provisioned
PASS  G3 freshness budget    cadence 24 vs tightest budget 168
FAIL  G4 stability clause    jump p95 0.540 vs clause 0.1
PASS  G5 measurable effect   holdout 5%, rdd logging True
PASS  G6 closing lag         d = 48, missing: none

BLOCKED (fail_closed)
Le candidat (Timestral-28M, 20 000 séries, refit quotidien) est bloqué : un refit quotidien publie au quantile 0,95 des sauts de 54 % de l’échelle au 95e percentile, au-delà du seuil de 10 %. Avec l’exigence de fréquence à la place (4,2 % d’origines révisées, pour un plafond de 15 %), il passe. Le choix entre les deux relève du métier ; la porte de déploiement oblige simplement à l’expliciter.
9. Mesurer l’effet d’un réentraînement#
Dernière question : une fois la politique en place, comment savoir si réentraîner a amélioré les prévisions ? Une réponse fréquente est un tableau de bord qui compare l’erreur avant et après chaque refit.
Ce tableau de bord est biaisé par construction. Le refit se déclenche quand l’erreur récente dépasse un seuil. Or une erreur élevée vient en partie d’un vrai problème et en partie du hasard. Après le refit, le hasard ne se répète pas forcément, et l’erreur baisse même si le refit n’a rien changé. C’est la régression vers la moyenne. La mesure est exacte ; c’est la règle de sélection qui produit l’écart.
Pour le chiffrer, j’ai simulé 400 000 séries, chacune avec un biais lié à l’âge du modèle, et un refit qui retire 30 % de ce biais. Effet réel sur les séries déclenchées, mesuré par randomisation : −0,1053.
| Dispositif | Estimation | Lecture |
|---|---|---|
| tableau de bord avant/après | −0,3119 | environ trois fois l’effet réel |
| placebo : même tableau de bord, refit sans effet | −0,2072 | 197 % de l’effet réel, sans aucun changement |
| A/B parmi les séries déclenchées | −0,0993, IC [−0,1141 ; −0,0844] | l’intervalle contient l’effet réel |
| A/B, placebo | +0,0066, IC [−0,0102 ; +0,0234] | zéro est dans l’intervalle |
Environ 66 % de l’amélioration affichée par le tableau de bord vient de la régression vers la moyenne. L’écart dépend aussi du seuil :
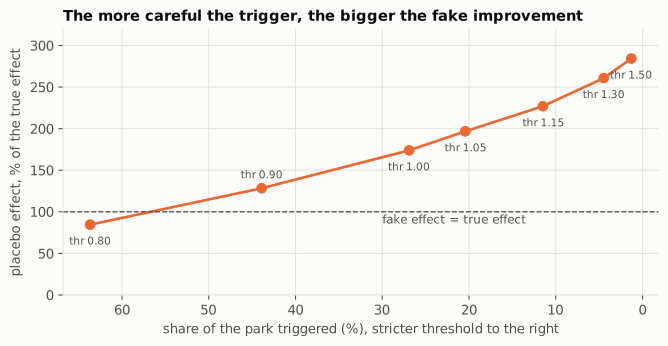
Plus le seuil est strict, plus l’effet placebo est grand : 85 % de l’effet réel quand 64 % du parc se déclenche, 284 % quand seulement 1,3 % se déclenche. Un seuil strict retient les séries dont l’erreur récente doit le plus au hasard, et dont l’erreur baisse donc le plus d’elle-même.
Le groupe témoin et son coût#
L’approche classique est un groupe témoin (holdout) : laisser sans refit une petite part des séries déclenchées, tirée au hasard, et comparer. Avec 5 % de témoins, l’A/B estime l’effet à ±0,035 près. Le plan évaluait le coût de ce témoin à 0,0057 d’erreur supplémentaire « sur le parc ». C’est en fait le coût par série déclenchée. Comme seules 20 % des séries se déclenchent, le coût par série du parc est de 0,0012, cinq fois moins.
La régression sur discontinuité au seuil#
Le plan concluait que réentraîner 100 % des séries déclenchées rend l’effet « incalculable par construction ». C’est vrai pour l’effet moyen. Mais une règle à seuil déterministe correspond au dispositif d’une régression sur discontinuité (RDD) : les séries juste sous le seuil et juste au-dessus sont comparables, et seul le refit les distingue. Une régression linéaire locale de chaque côté mesure le saut au seuil.
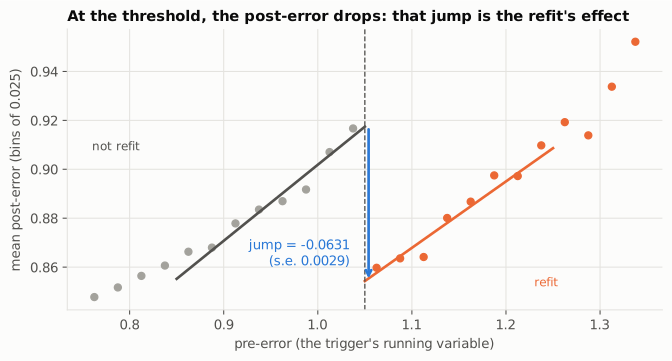
Sans aucun témoin, la RDD retrouve −0,059 à −0,064 pour un effet réel de −0,0625 au seuil, et le placebo correspondant est proche de zéro. Elle ne demande pas de groupe témoin, seulement d’avoir enregistré la variable qui déclenche le refit.
Elle a une limite : elle mesure l’effet au seuil, pas l’effet moyen sur les séries déclenchées (−0,1053), parce que les séries très au-dessus du seuil ont un biais plus fort et bénéficient davantage du refit. Les deux dispositifs répondent à deux questions différentes :
- « faut-il abaisser un peu le seuil ? » relève de la RDD ;
- « que rapporte la politique de réentraînement en moyenne ? » demande le groupe témoin.
Dans le contrat, j’ai donc demandé l’un ou l’autre : un groupe témoin permanent, ou l’enregistrement de la variable de déclenchement.
10. Ce que j’en retiens#
Ces constats valent pour les dispositifs étudiés ici : un banc simulé, un modèle analytique simple, une année de consommation électrique. Je les présente comme tels.
- Les trois attentes ne mènent pas à la même fréquence. Sur le banc, le réentraînement continu donne la meilleure exactitude, mais publie des révisions sur 12,6 % des origines ; le mensuel publie rarement, mais par sauts de 293 % de l’échelle.
- Sur le banc, la détection compte moins que ce qui la suit. Le même détecteur parfait passe d’un MASE de 1,37 à 0,88 selon la fenêtre de réajustement et le calendrier qui l’accompagne. Avec un CUSUM réel, redémarrer la fenêtre dégrade au contraire le résultat : l’intérêt de cette approche dépend de la fiabilité de la détection.
- La latence de clôture a modifié trois mesures : l’erreur du backtest (environ 6 %), la comparaison à la baseline sur données réelles, et le ciblage du CUSUM (de 40,9 % à 20,0 %).
- La taille et la fréquence des révisions évoluent en sens opposés, et le churn moyen ne distingue pas un modèle stable d’un modèle figé.
- Dans le modèle du niveau local, la fenêtre et la cadence agissent sur deux termes distincts de l’erreur. Je n’ai vérifié cette séparation que dans ce modèle ; avec des ruptures (partie 4), les deux choix interagissent.
- L’écart de fraîcheur entre quantiles venait en grande partie de la calibration et de la baseline. Après correction : un facteur 2 en simulation, autour de 1 sur les données réelles.
- Sur les données d’électricité, le budget de fraîcheur varie fortement selon le trimestre, de 720 heures à zéro.
- La comparaison avant/après surestime l’effet d’un réentraînement déclenché par seuil, et d’autant plus que le seuil est strict. Un groupe témoin ou une RDD au seuil permettent d’estimer l’effet, chacun pour une question différente.
Questions encore ouvertes. Je n’ai pas testé de détecteur réel plus précis que le CUSUM, ni de fenêtre redémarrée avec une longueur minimale. La transposition des latences publiées de Timestral à un parc horaire n’est pas mesurée. Et je n’ai pas cherché pourquoi le deuxième trimestre 2014 fait exception.
La suite. La partie 9 portait sur un effet de sélection lié à un déclenchement par seuil. Le même mécanisme se retrouve dans d’autres interventions, par exemple une promotion lancée après un creux de demande. La prochaine veille portera sur l’inférence causale appliquée aux séries temporelles : contrôle synthétique, effets d’une intervention datée, placebos dans l’espace et dans le temps.
Reproduire et aller plus loin#
Le code, les sept notebooks et les 55 tests sont dans le dépôt
gwils28/W44_retraining_frequency
(Python 3.13, versions verrouillées par uv). Chaque tableau de cet article sort d’une commande
uv run w44 …, avec des graines fixées. Le jeu de données réel est vérifié par son empreinte sha256
avant usage, et le protocole qui le concerne a été commité avant les résultats.
Sources
- Zanotti, On the retraining frequency of global models in retail demand forecasting, Machine Learning with Applications (DOI 10.1016/j.mlwa.2025.100769).
- Zanotti, Analyzing the retraining frequency of global forecasting models: towards more stable forecasting systems, arXiv, 2026.
- Katz, Cost-sensitive retraining via posterior learning debt, arXiv, 2026.
- Kwak, Jung, Park, Pseudo-Label-Triggered Retraining from Forecast Errors for Online Time Series Forecasting, arXiv, 2026.
- Mistral AI, Timestral, annonce du 15 octobre 2026, et la licence des poids sur le Hub (
mistralai/Timestral-*). - Open Inference Protocol V2, spécification.
- Données : Godahewa et al., Monash Electricity Hourly, Zenodo, CC-BY-4.0.