Temps de lecture : environ 30 minutes. Les formules sont toujours suivies de leur intuition : on peut les survoler sans perdre le fil. Le dépôt est en anglais, ses figures aussi.
Note de transparence. Ces travaux ont été menés à titre personnel, dans un but d’apprentissage, avec l’assistance d’une IA :
- pour le code, la relecture technique et méthodologique ;
- pour comprendre les outils et les méthodes mathématiques ;
- pour l’aide à la rédaction, la traduction et la correction du texte ;
- pour générer l’image de couverture de l’article.
Le choix du sujet, le protocole, la vérification des résultats et les conclusions sont les miens, et j’en assume les erreurs. Comment j’utilise l’IA
Cet article restitue trois semaines de veille active sur l’inférence causale appliquée aux séries temporelles, annoncées à la fin de l’article sur la fréquence de réentraînement. Le plan de départ tenait en quatre blocs : deux articles récents à lire à la source, un contrefactuel à construire et à valider par placebo, une décision d’architecture pour une mesure d’incrémentalité en continu, et l’article fondateur de Brodersen et ses collègues à relire. Son critère de réussite : un effet réel dont l’intervalle exclut zéro, un effet placebo dont l’intervalle contient zéro. Je l’ai atteint, puis j’ai cherché ce qu’il garantit vraiment, sur un panel où la vérité est connue. Tout est reproductible dans le dépôt time_series_causal_statistics.
En bref. Les principaux résultats, avec leur périmètre :
- Le critère du plan est atteint sur une vérité connue et sur Volkswagen : −20,9 % [−33,9 % ; −1,7 %] sur le cours de VW après l’avis de l’EPA, douze fausses dates toutes propres.
- Le placebo dans le temps ne valide que le modèle pré-intervention. Sur 100 panels où un contrôle est contaminé par l’intervention, il est vert aussi souvent que sur des panels propres. La contamination demande le placebo dans l’espace ; une relation qui casse à la date de l’intervention n’est vue par rien.
- Un placebo qui « trouve » un effet est en partie une propriété du placebo lui-même : avec une pré-période raccourcie, il se déclenche sur 11 à 17 % des panels propres, pour un nominal de 5 %.
- Les estimateurs statiques (OLS sur les contrôles, contrôle synthétique convexe, différence de différences) sont aussi précis que le niveau local sur l’estimation ponctuelle, et six à sept fois trop confiants : 80 % de faux positifs à effet nul.
- Le port Python du CausalImpact de Google donne les mêmes estimations ponctuelles avec des intervalles deux fois plus étroits. C’est son a priori par défaut sur l’écart-type du niveau, pas les données : sur 30 panels à vérité connue, il couvre 77 % du temps, contre 90 % à la main.
1. Le problème : une unité, deux mondes#
L’effet causal d’une intervention sur une unité à la date \(t\) est la différence entre l’observé, \(y_t\), et ce qu’on aurait observé sans l’intervention, \(y^0_t\). La seconde quantité n’existe plus dès que l’intervention a eu lieu : une analyse contrefactuelle est donc une prévision de \(y^0_t\) sur la post-période, et l’effet est l’écart entre l’observé et cette prévision.
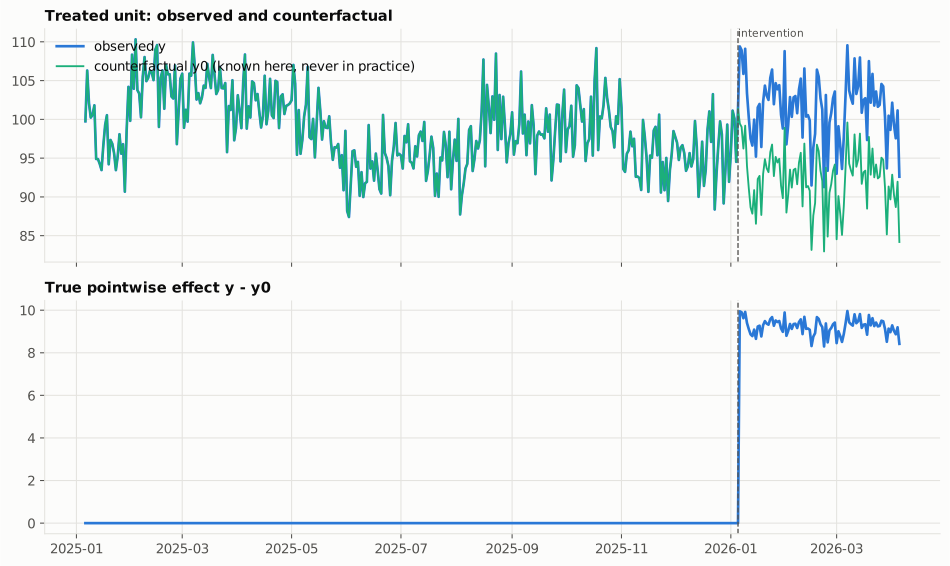
Tout l’enjeu est de rendre cette prévision crédible et honnête sur son incertitude. Mais une bonne prévision n’est pas un modèle causal. Le contrefactuel se construit à partir de séries de contrôle : des unités comparables, non touchées, dont la relation avec l’unité traitée, apprise avant la date, est extrapolée après. Trois hypothèses portent le résultat, et aucune n’est visible dans la qualité de l’ajustement pré-intervention :
| Hypothèse | Ce qu’elle signifie pour une série traitée | Ce qui la teste |
|---|---|---|
| la date d’intervention est « comme aléatoire » étant donné le passé | pas d’anticipation, pas d’événement simultané propre à l’unité traitée | placebo dans le temps : une fausse date dans la pré-période doit donner un effet dont l’intervalle contient zéro |
| les contrôles ne sont pas affectés, directement ni par ricochet | pas d’interférence : la promotion sur A ne cannibalise pas B, utilisé comme contrôle | placebo dans l’espace : chaque contrôle traité comme s’il était l’unité d’intérêt, à la vraie date |
| la relation pré-intervention persiste | les coefficients qui lient contrôles et cible restent valables après la date | diagnostics de stabilité sur la pré-période, et couverture sur un panel à vérité connue |
Le protocole : ajuster un modèle structurel sur la pré-période seulement, prévoir le contrefactuel avec un intervalle à 95 %, puis rejouer la même analyse avec une fausse date placée dans la pré-période. Je l’ai appliqué sur un panel semi-synthétique à vérité connue, puis sur le panel Volkswagen du dieselgate.
2. Ce que disent les travaux récents#
Time-Aware Synthetic Control (Rho, Illick, Narasipura, Abadie, Hsu et Misra, arXiv 2601.03099, janvier 2026). Le contrôle synthétique classique traite les indices temporels de la pré-période comme interchangeables ; TASC encode le temps par un modèle espace-état linéaire gaussien appris par EM. Il gagne quand le bruit d’observation est fort, perd face au contrôle synthétique robuste quand il est faible. Deux écarts avec le plan : Alberto Abadie est le quatrième de six auteurs, pas le signataire principal ; et les « intervalles plus étroits » que CausalImpact sont une affirmation sur la largeur, sans aucune couverture rapportée. La partie 9 mesure ce qu’un intervalle étroit peut coûter.
When are time series predictions causal? (Carlson et Shephard, arXiv 2603.20394, mars 2026). L’article conceptuel. Son théorème central tient en une phrase : sous une condition d’assignation adaptée, une différence de prévisions est un effet causal. Sans cette condition, c’est une différence de prévisions. Le tableau de la partie 1 est ma traduction de cette condition pour une seule série traitée.
Brodersen, Gallusser, Koehler, Remy et Scott (2015), Inferring causal impact using Bayesian structural time-series models, Annals of Applied Statistics. Un espace d’états assemblé par blocs (niveau local, tendance, saisonnalité, régression sur les contrôles), des a priori sur les variances et les coefficients, inféré par Gibbs ; la distribution prédictive est définie conjointement sur la post-période pour que la structure sérielle se propage dans l’effet cumulé. Trois choses m’ont servi : leur étude de simulation note la méthode par deux courbes, puissance et couverture ; leur troisième analyse applique le modèle aux régions non traitées et exige un résultat nul, ce qui est le placebo dans l’espace ; et leurs trois hypothèses nommées : covariables non affectées par l’intervention, relation pré-intervention qui persiste, structure du modèle intacte. Le plan ne citait que la première.
3. Le modèle : un niveau local et une régression sur les contrôles#
J’ai construit le modèle à la main avec statsmodels, pour savoir ce qu’il y a dedans, et gardé
le port de Google comme contrôle croisé (partie 9). C’est celui de Brodersen sans sa couche
bayésienne :
L’intuition. La régression \(\beta' x_t\) explique la part que l’unité traitée partage avec ses contrôles ; le niveau \(\mu_t\), une marche aléatoire, absorbe ce que la cible fait toute seule. Les deux variances sont estimées par maximum de vraisemblance sur la pré-période seulement ; le contrefactuel est la prévision du filtre de Kalman sur la post-période, simulée en trajectoires conjointes pour l’intervalle de l’effet cumulé. Trois modèles sur le même panel :
| statique | niveau local | tendance locale | |
|---|---|---|---|
| RMSE à un pas (pré-période) | 3,10 | 2,94 | 2,98 |
| R² à un pas | 0,57 | 0,61 | 0,61 |
| Ljung-Box sur les résidus (p) | 0,000 | 0,94 | 0,90 |
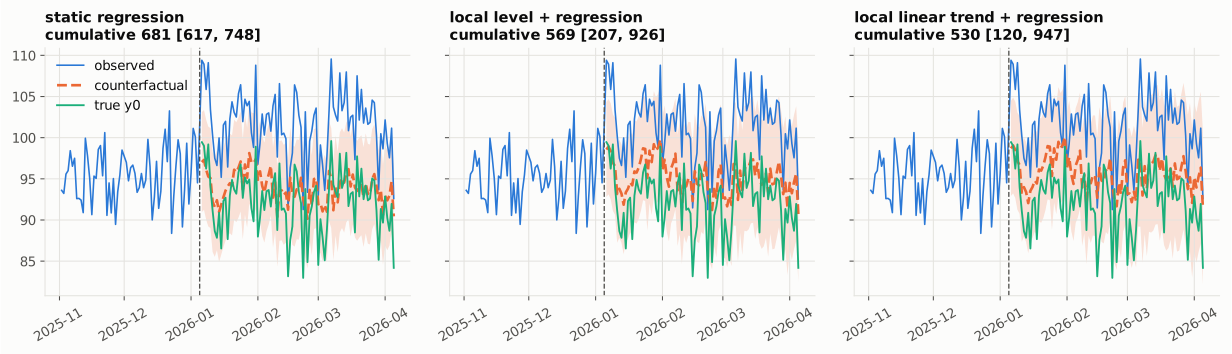
| effet cumulé estimé (vérité 831) | 681 [617 ; 748] | 569 [207 ; 926] | 530 [120 ; 947] |
Les résidus de la régression statique sont autocorrélés : il reste une composante lente, que le niveau local absorbe. Mais la vraie différence est dans la prévision : le modèle statique suppose que la part inexpliquée est un bruit indépendant chaque jour, le niveau local suppose qu’elle peut dériver.
La variance de prévision d’une régression statique est constante. Un niveau local ajoute une variance linéaire en l’horizon \(h\), donc un intervalle en \(\sqrt h\) ; une tendance linéaire locale ajoute une pente aléatoire et la variance croît en \(h^3\). Pour l’effet cumulé, ces puissances montent de deux.
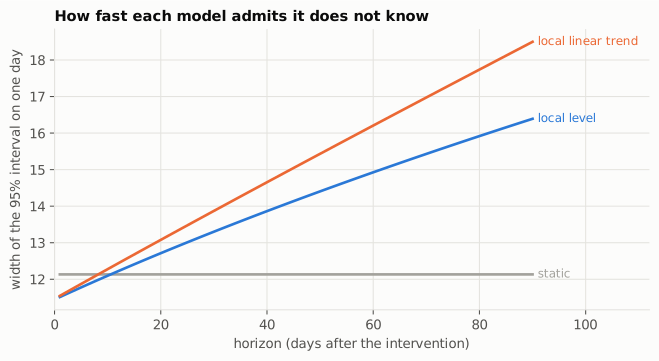
Sur ce panel, l’intervalle statique manque la vérité et celui du niveau local la contient. Lequel est le bon est une question de couverture, que la partie 5 mesure sur 100 panels.
Une deuxième source d’incertitude. La prévision au maximum de vraisemblance ignore que les paramètres sont eux-mêmes estimés. CausalImpact les intègre par MCMC ; l’équivalent fréquentiste bon marché est de les tirer dans la normale asymptotique du maximum de vraisemblance et de mélanger la prévision sur ces tirages. Avec 365 jours de pré-période, l’intervalle cumulé bouge à peine : [207 ; 926] devient [203 ; 914].
4. Le protocole sur une vérité connue#
Le panel : une unité traitée et cinq contrôles, 365 jours avant l’intervention et 90 après. Toutes les unités chargent sur deux facteurs latents (des marches aléatoires) et un motif hebdomadaire, avec des poids propres, plus un petit niveau propre en marche aléatoire et un bruit d’observation. Les contrôles sont des proxys bruités de ce qui fait bouger la cible, pas des copies. L’effet planté est une hausse de 10 % sur la post-période, soit 831 unités cumulées, et le contrefactuel \(y^0\) est conservé pour noter chaque estimateur.
| effet relatif, IC 95 % | effet cumulé | probabilité de queue | |
|---|---|---|---|
| intervention réelle (vérité 10 %, 831) | +6,6 % [+2,3 % ; +11,3 %] | 569 [207 ; 926] | 0,000 |
| placebo au jour 243, données tronquées à la vraie date | +0,3 % [−5,3 % ; +6,7 %] | 38 [−655 ; 742] | 0,461 |
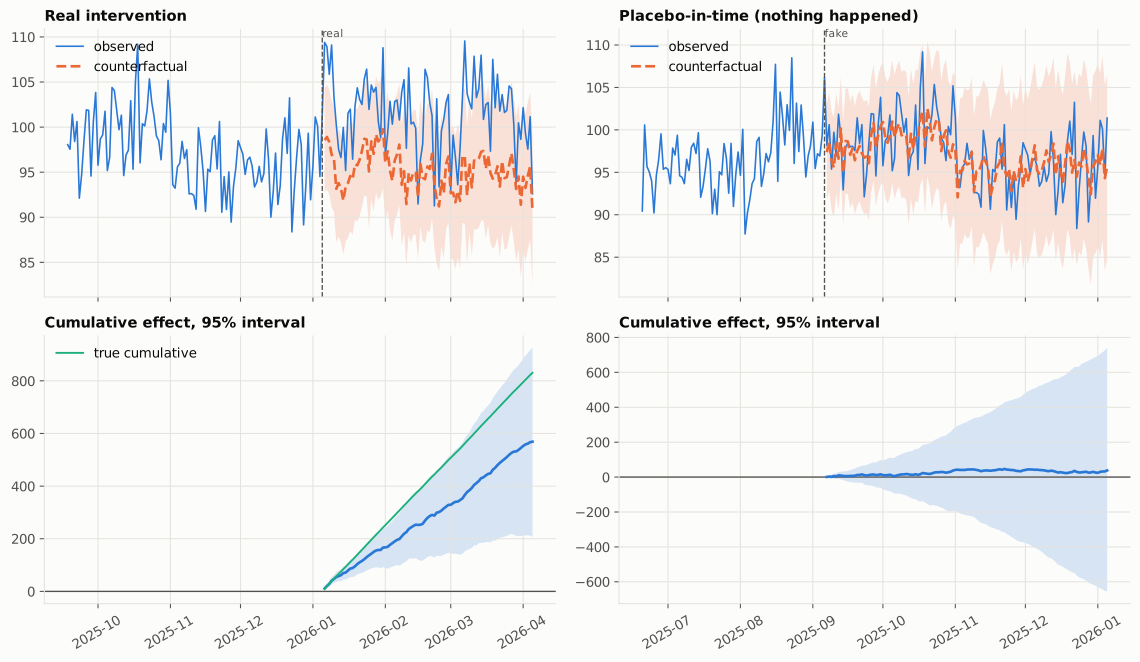
Les deux critères sont atteints : l’intervalle réel exclut zéro et contient la vérité, l’intervalle placebo contient zéro. Le placebo est calculé sur des données tronquées à la vraie date, pour qu’aucune donnée traitée n’entre dans l’analyse.
Un panel prouve que le protocole tourne, pas que la méthode est bonne. Deux extensions rendent le placebo plus informatif :
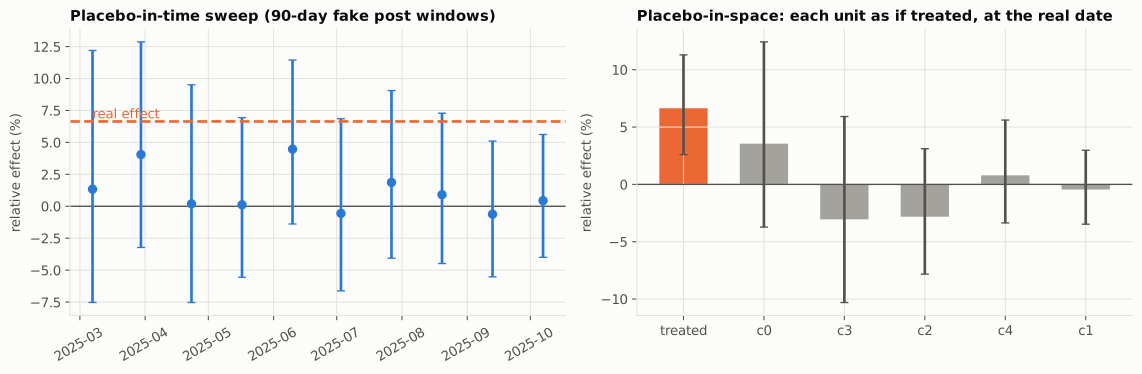
- Le placebo dans le temps comme balayage. Une fausse date est un tirage. Huit fausses dates réparties sur la pré-période donnent la distribution des « effets » que le design produit quand il ne se passe rien : c’est l’étalon de l’effet réel. Ici, les huit intervalles contiennent zéro.
- Le placebo dans l’espace comme classement. Chaque contrôle est traité à son tour comme l’unité d’intérêt, à la vraie date. L’unité réelle se classe première sur six par effet absolu.
5. L’intervalle à 95 % est-il un intervalle à 95 % ?#
Deux courbes notent la méthode : la part des intervalles qui excluent zéro selon l’effet réel (la puissance, et à effet nul le taux de faux positifs), et la part qui contient la vérité (la couverture, qui doit rester près de 95 %). Je les ai tracées sur 100 panels par taille d’effet, pour l’intervalle au maximum de vraisemblance, pour l’intervalle mélangé sur des tirages de paramètres, et pour le placebo dans le temps sur les mêmes panels. Comme l’effet ne touche ni la pré-période ni les contrôles, couverture, largeur et biais sont les mêmes à toutes les tailles d’effet ; seule la détection bouge.
| estimateur | couverture | faux positifs à 0 % | détection à 1 % | 2 % | 5 % | 10 % | largeur moyenne |
|---|---|---|---|---|---|---|---|
| niveau local, intervalle MLE | 0,92 | 0,08 | 0,10 | 0,15 | 0,51 | 0,94 | 874 |
| niveau local, 40 tirages de paramètres | 0,93 | 0,07 | 0,07 | 0,13 | 0,47 | 0,92 | 912 |
| placebo dans le temps sur les mêmes panels (pré-période de 243 jours, vérité 0) | 0,89 | 0,11 | 1 321 |
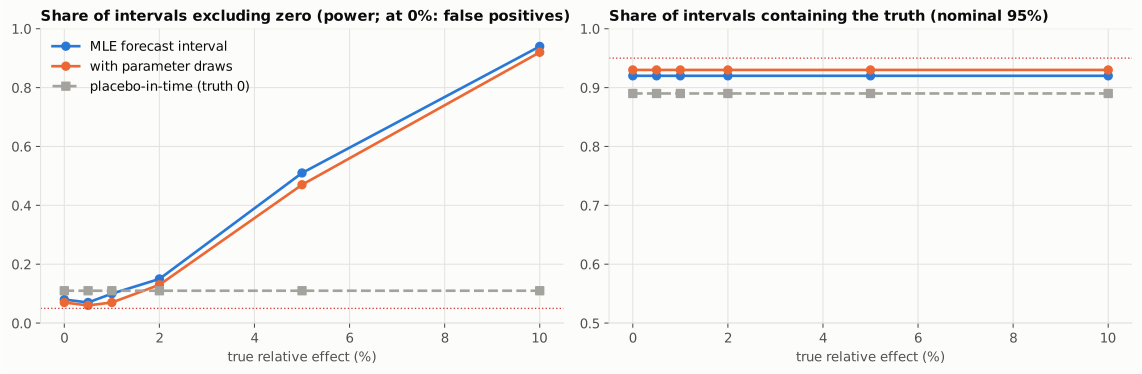
La détection est modeste. Une hausse de 1 % est invisible, 5 % est vue une fois sur deux, 10 % presque toujours, avec 90 jours de post-période. C’est l’ordre de grandeur de la simulation de Brodersen.
Le placebo se déclenche plus souvent que 5 %. Les fenêtres placebo ont une pré-période plus courte (243 jours au lieu de 365) et un intervalle moins bien calibré : 11 % de faux positifs. Un placebo sur neuf trouve donc un effet sur un design parfaitement valide. Lire le balayage contre son propre taux sur panels propres est plus juste qu’une date isolée contre un seuil de 5 %.
La longueur de la pré-période compte, parce qu’une variance demande plus de points qu’une moyenne. Couverture sur 50 panels par cellule, à 5 % d’effet :
| pré-période (jours) | 60 | 120 | 240 | 365 | 730 |
|---|---|---|---|---|---|
| niveau local, MLE | 0,72 | 0,84 | 0,92 | 0,88 | 0,92 |
| niveau local, tirages de paramètres | 0,88 | 0,90 | 0,92 | 0,92 | 0,92 |
| OLS sur les contrôles | 0,18 | 0,20 | 0,22 | 0,10 | 0,16 |
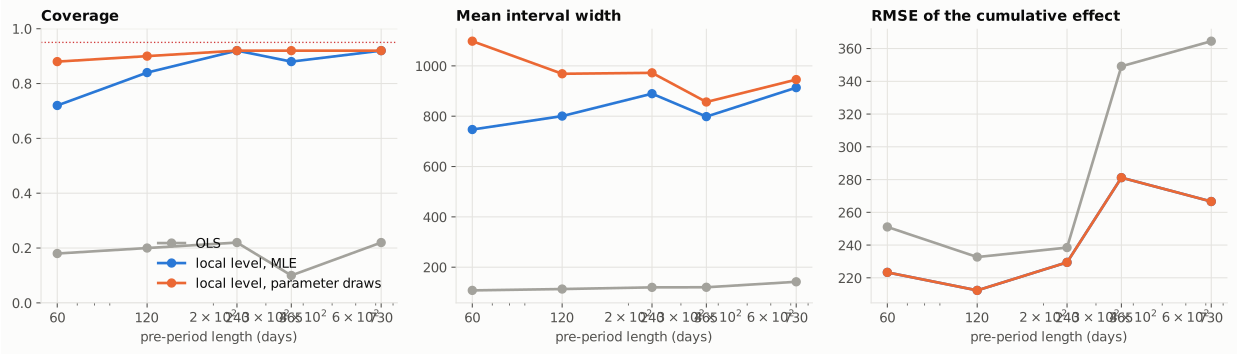
Les tirages de paramètres servent sur les pré-périodes courtes, où la variance de niveau estimée peut s’écraser à zéro et redonner un modèle statique trop confiant. Un a priori corrige cela aussi, et c’est une raison honnête pour laquelle CausalImpact en met un sur l’écart-type du niveau. La partie 9 en montre le revers.
6. Neuf estimateurs sur les mêmes panels#
Chaque estimateur s’ajuste sur la pré-période et renvoie l’effet cumulé avec l’intervalle qu’un praticien calculerait pour lui (erreurs indépendantes pour les plus simples). Mêmes 100 panels, effets de 0 et 5 %.
| estimateur | couverture | faux positifs à 0 % | détection à 5 % | largeur | RMSE |
|---|---|---|---|---|---|
| moyenne de la pré-période | 0,10 | 0,90 | 0,88 | 262 | 954 |
| tendance seule (tendance locale, sans contrôle) | 0,96 | 0,04 | 0,15 | 2 224 | 559 |
| différence de différences (moyenne des contrôles) | 0,12 | 0,88 | 0,90 | 148 | 400 |
| OLS sur les contrôles, intervalle iid | 0,19 | 0,81 | 0,93 | 124 | 274 |
| contrôle synthétique convexe, intervalle iid | 0,17 | 0,83 | 0,91 | 142 | 335 |
| régression statique en espace d’états | 0,21 | 0,79 | 0,93 | 135 | 274 |
| niveau local + régression (MLE) | 0,94 | 0,06 | 0,57 | 886 | 227 |
| niveau local + régression, tirages de paramètres | 0,95 | 0,05 | 0,53 | 938 | 227 |
| tendance locale + régression | 0,92 | 0,08 | 0,44 | 1 065 | 280 |
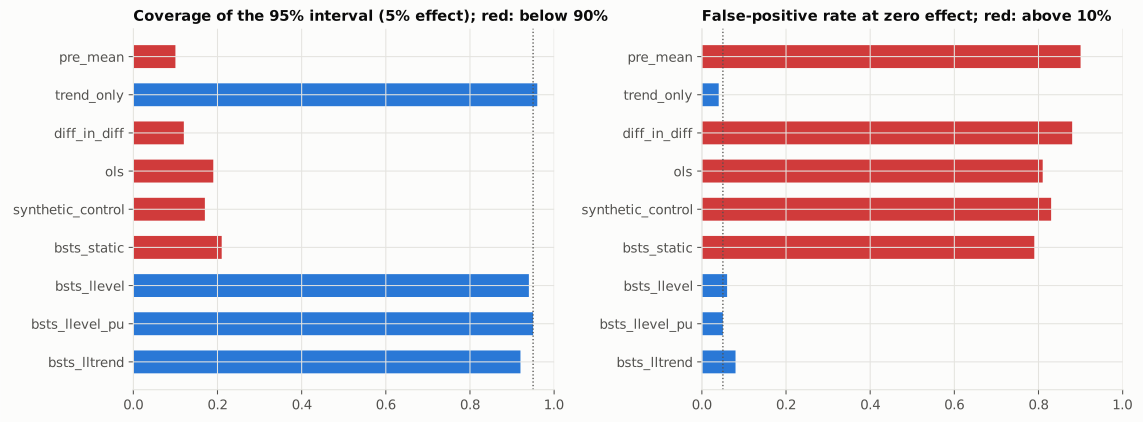
- OLS sur les contrôles et la régression statique en espace d’états sont le même estimateur. Estimation ponctuelle presque aussi précise que le niveau local (RMSE 274 contre 227), intervalle six à sept fois trop étroit : 80 % de faux positifs à effet nul. Quatre promotions sur cinq qui n’ont rien fait seraient déclarées efficaces. C’est la version mesurée des « inférences sur-optimistes » que Brodersen cite, d’après Bertrand, Duflo et Mullainathan.
- Le contrôle synthétique convexe est presque sans biais mais hérite du même intervalle iid. La méthode classique le sait : elle rapporte des rangs de permutation plutôt que des intervalles.
- La différence de différences est moins bonne sur les deux tableaux : la moyenne des contrôles est un mauvais contrôle synthétique quand les chargements diffèrent entre unités.
- L’extrapolation de tendance sans contrôle couvre, avec un intervalle deux fois et demie plus large, et détecte une hausse de 5 % une fois sur sept.
- Le niveau local est le seul estimateur avec une couverture proche du nominal et des faux positifs près de 5 %. La tendance locale paie sa composante supplémentaire en largeur et en puissance.
Ce tableau est, de ces trois semaines, le meilleur argument pour le placebo : le placebo dans le temps d’un design OLS se déclencherait lui aussi quatre fois sur cinq.
7. Quand le design casse : qui attrape quoi#
Le vrai livrable n’est pas l’effet, mais la capacité à dire pourquoi une mesure est invalide. J’ai planté quatre violations une à une, avec une hausse de 5 %, 100 panels par scénario :
- contrôle cannibalisé : l’effet traité est retranché, un pour un, des contrôles c0 et c1 (une promotion sur A qui mange les ventes de B et C, utilisés comme contrôles) ;
- halo sur les contrôles : la même quantité est ajoutée à c0 et c1 ;
- tendance propre : l’unité traitée dérive de +0,1 par jour toute seule depuis le premier jour (environ 36 % par an sur un niveau de 100) ;
- rupture de relation : les chargements de l’unité traitée sur les facteurs communs changent de +30 % à la date de l’intervention.
Quatre vérifications sur chacune : le placebo dans le temps, le placebo dans l’espace, un test de Chow sur les différences entre les deux moitiés de la pré-période, et le biais contre la vérité, qu’on ne connaît jamais en pratique. La ligne « propre » donne le taux de fausse alerte de chaque vérification.
| scénario | couverture | biais relatif | placebo temps se déclenche | placebo espace signale c0 / c1 | signale un contrôle propre | Chow rejette |
|---|---|---|---|---|---|---|
| propre | 0,89 | −0,5 % | 0,17 | 0,10 / 0,08 | 0,24 | 0,15 |
| contrôle cannibalisé | 0,86 | +26 % | 0,17 | 0,39 / 0,36 | 0,34 | 0,15 |
| halo sur les contrôles | 0,82 | −27 % | 0,17 | 0,38 / 0,45 | 0,31 | 0,15 |
| tendance propre | 0,69 | +71 % | 0,39 | 0,10 / 0,08 | 0,24 | 0,15 |
| rupture de relation | 0,56 | −11 % | 0,17 | 0,10 / 0,08 | 0,24 | 0,15 |
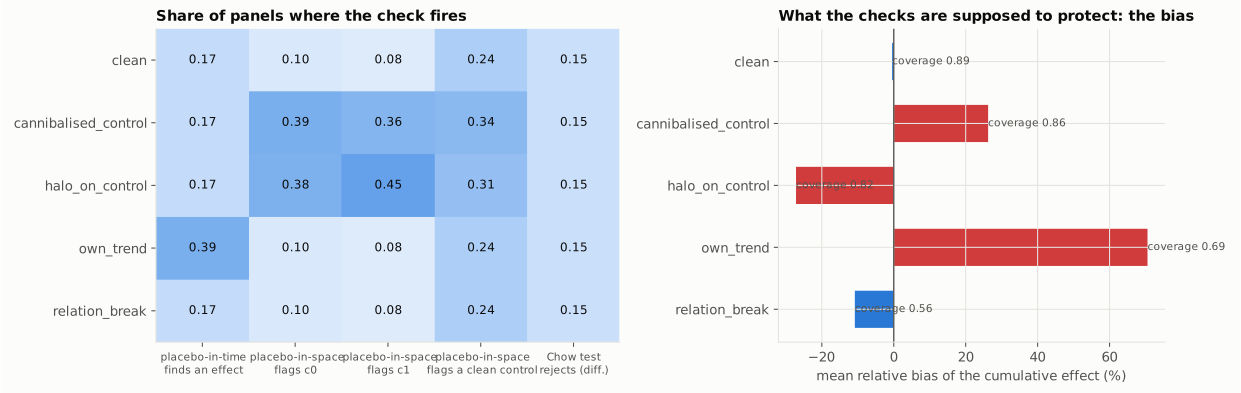
- Contrôle cannibalisé et halo. Le biais est grand (+26 % et −27 %), et pourtant le placebo dans le temps est exactement aussi souvent vert que sur les panels propres : la contamination commence à l’intervention, rien ne cloche avant. Le placebo dans l’espace signale chaque contrôle contaminé environ quatre fois plus souvent qu’un contrôle propre : de la puissance, mais loin de la certitude. Il signale aussi plus souvent des contrôles propres : un donneur contaminé contamine les placebos qui l’utilisent.
- Tendance propre. Le placebo dans le temps se déclenche dans 39 % des panels, plus de deux fois son taux propre : une unité qui dérive toute seule produit des « effets » à n’importe quelle date. Le biais est de +71 %, parce que le niveau local prévoit à plat et que la dérive continue.
- Rupture de relation. Biaisée, sous-couverte, et aucune vérification ne se déclenche au-dessus de son taux propre. Une relation qui cesse de tenir à la date de l’intervention est indiscernable, dans les données, d’un effet de l’intervention : l’hypothèse est intestable par construction. Les seules défenses sont extérieures aux données : une raison de croire que la relation persiste, et la réconciliation métier de la partie 10.
Isoler un contrôle contaminé#
Quand le placebo dans l’espace signale plusieurs contrôles, l’un peut être le coupable et les autres ses victimes. La procédure retire le pire (la plus petite probabilité de queue), relance la vérification sur le reste, et recommence jusqu’à ce que rien ne soit signalé.
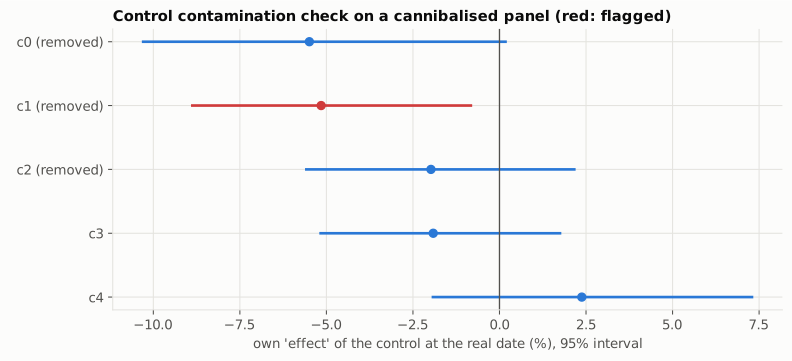
Sur ce panel, l’isolation retire c1, puis c0, puis un contrôle propre, c2. Avec tous les contrôles, l’effet est estimé 20 % trop haut ; avec les deux gardés, il est couvert mais très imprécis. Retirer des contrôles échange du biais contre de la variance, et avec cinq donneurs l’échange est mauvais. D’où la règle de la partie 10 : un réservoir de 10 à 20 donneurs choisis avant la campagne parmi des produits qui ne peuvent pas interagir avec le produit promu. La vérification est une garde, pas une procédure de sélection.
8. Un cas réel : Volkswagen, 18 septembre 2015#
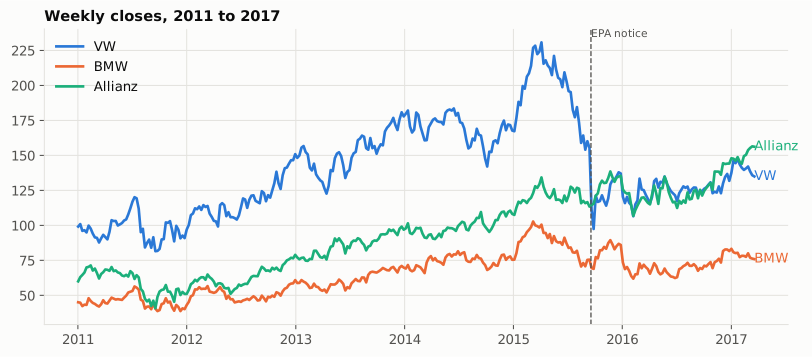
J’ai pris le panel public que le port de CausalImpact utilise comme fixture de test : les cours hebdomadaires de clôture de Volkswagen, BMW et Allianz, 325 semaines de janvier 2011 à mars 2017. L’intervention est datée : l’avis de violation de l’EPA américaine contre Volkswagen, le vendredi 18 septembre 2015. Ici aucune vérité n’est disponible, et chaque affirmation doit être défendue par un placebo ou une analyse de sensibilité.
La première chose à remarquer#
La semaine du dimanche 20 septembre 2015 contient déjà le krach : VW perd 28 %. La pré-période s’arrête donc au 13 septembre (246 semaines) et la post-période commence au 20 septembre (79 semaines). Mais BMW baisse la même semaine (−8 %) pendant qu’Allianz gagne 1 % : tout le secteur a été re-tarifé avant de se reprendre en octobre. Si BMW a réagi au même événement, ce n’est pas un contrôle non traité.
La relation pré-intervention est-elle stable ?#
Une régression glissante sur 52 semaines montre des coefficients qui se promènent : trois cours co-évoluent par le facteur de marché, mais les chargements ne sont pas une loi. Un test de Chow entre les deux moitiés de la pré-période, calculé sur les différences hebdomadaires, ne rejette pas la stabilité (p = 0,42). Assez stable pour essayer, pas assez pour se passer de placebo.
L’effet, avec BMW et Allianz comme contrôles#
| valeur | |
|---|---|
| effet moyen par semaine | −33,5 [−65,1 ; −2,1] |
| effet cumulé sur 79 semaines | −2 650 [−5 140 ; −169] |
| effet relatif | −20,9 % [−33,9 % ; −1,7 %] |
| probabilité de queue | 0,018 |
| ajustement à un pas sur la pré-période | R² 0,99, couverture 0,92, Ljung-Box p = 1,0 |
| coefficients | BMW 0,63, Allianz 0,30 |
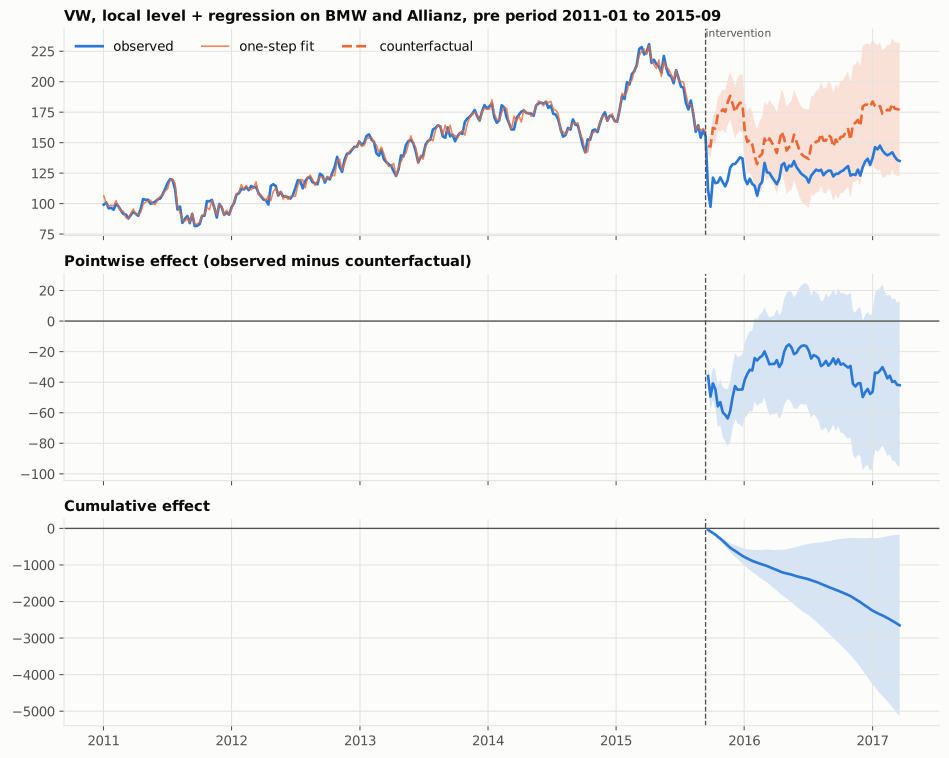
L’intervalle exclut zéro, mais de peu, et il s’élargit vite : 79 semaines est un long horizon pour un niveau en marche aléatoire. VW a coté environ un cinquième sous son contrefactuel pendant les dix-huit mois suivants. Le R² à un pas de 0,99 ne dit rien : la prévision à un pas d’une marche aléatoire est toujours excellente. Plus parlant : la dispersion des résidus après la date vaut 3,4 fois celle d’avant.
Le placebo dans le temps, un an plus tôt#
Je fais comme si l’intervention avait eu lieu le 14 septembre 2014, sur des données qui s’arrêtent au 13 septembre 2015. L’effet estimé est bien indiscernable de zéro : +5,4 % [−8,2 % ; +23,1 %]. Puis le balayage : douze fausses dates entre février 2012 et mars 2015, fenêtres post de 26 semaines.
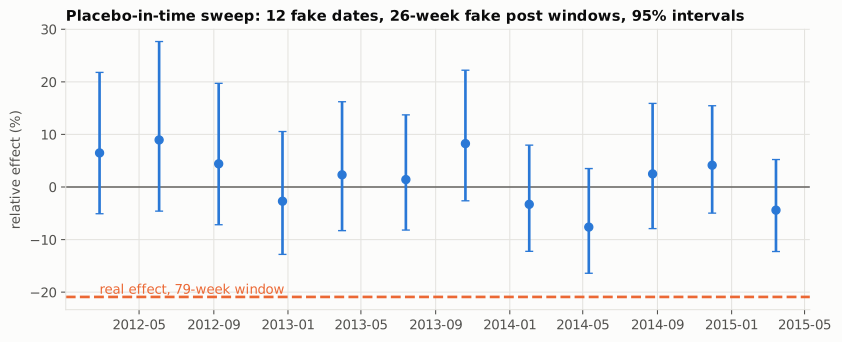
Les douze intervalles contiennent zéro, les estimations placebo se dispersent entre −7,6 % et +9,0 %, et l’effet réel est bien en dehors de ce nuage. C’est la moitié (b) du critère, celle qui rend la moitié (a) rapportable. Ce placebo valide le modèle pré-intervention ; il ne dit rien sur BMW, qui n’a été touché par rien dans les fenêtres placebo.
Les contrôles ont-ils été traités eux-mêmes ?#
La troisième analyse de Brodersen : chaque contrôle comme s’il était l’unité traitée, avec l’autre contrôle comme donneur, à la vraie date.
| effet propre sur 79 semaines | sur les 14 semaines après l’avis | |
|---|---|---|
| BMW (contrefactuel depuis Allianz) | −11,3 % [−27,3 % ; +13,8 %] | −1,5 % [−10,5 % ; +9,6 %] |
| Allianz (contrefactuel depuis BMW) | +14,7 % [−3,7 % ; +41,6 %] | +9,4 % [+1,0 % ; +19,3 %] |
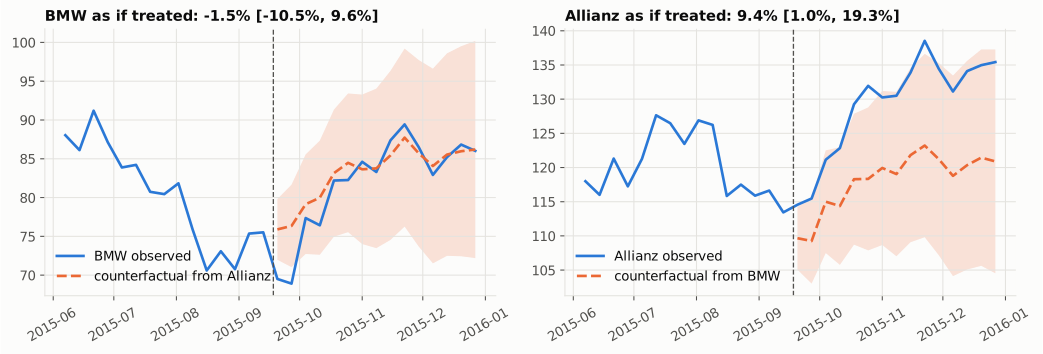
Avec deux contrôles, cette vérification est un miroir : « BMW a baissé par rapport à Allianz » et « Allianz a monté par rapport à BMW » sont le même fait. BMW a perdu 8 % puis repris 12 % en trois semaines, Allianz n’a pas bougé : BMW est un contrôle douteux, au moins à court terme. Plutôt que de trancher, j’ai rapporté l’effet sous chaque jeu de contrôles.
Sensibilité : quelle part de la réponse est un choix de modélisation ?#
| spécification | effet relatif | IC 95 % | exclut zéro |
|---|---|---|---|
| BMW + Allianz, niveau local (référence) | −20,9 % | [−33,9 ; −1,7] | oui |
| Allianz seul | −27,2 % | [−41,8 ; −2,8] | oui |
| BMW seul | −16,8 % | [−31,5 ; +5,9] | non |
| sans contrôle, tendance linéaire locale | −22,9 % | [−45,0 ; +27,2] | non |
| BMW + Allianz, régression statique | −30,1 % | [−31,0 ; −29,1] | oui |
| BMW + Allianz, tendance linéaire locale | −19,7 % | [−35,1 ; +4,4] | non |
| BMW + Allianz, log des cours | −4,3 % | [−8,4 ; +0,2] | non |
| BMW + Allianz, pré-période depuis 2013 | −21,5 % | [−34,9 ; −1,2] | oui |
| BMW + Allianz, pré-période depuis 2014 | −21,4 % | [−34,6 ; −1,5] | oui |
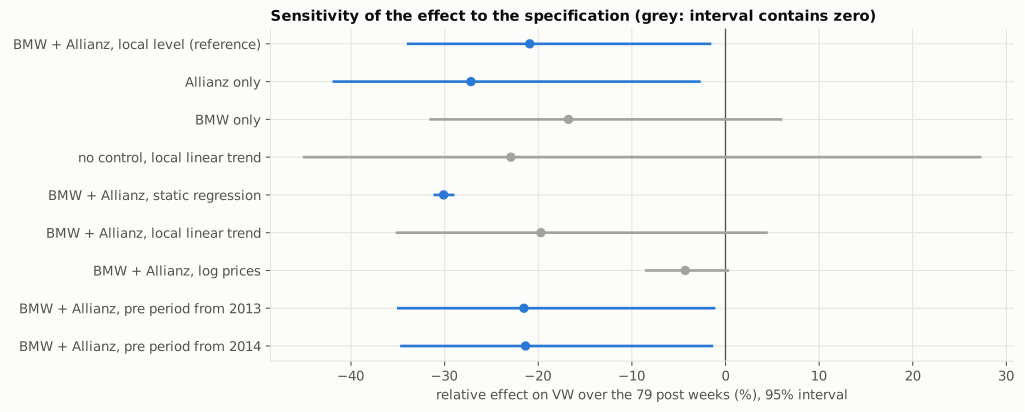
Toute spécification en prix avec un contrôle place l’estimation entre −15 % et −30 % environ, et le signe ne change jamais. Ce qui bouge, c’est l’intervalle : la régression statique est étroite avec une assurance que la partie 6 a montrée imméritée, la tendance linéaire locale trop incertaine à 79 semaines pour conclure, BMW seul non significatif. Le rapport défendable est un intervalle de −17 % à −27 %, avec la question du jeu de contrôles signalée.
Le modèle utilise-t-il l’ordre du temps ?#
Une vérification bon marché, inspirée de TASC : mélanger les lignes de la pré-période et réajuster. Une régression statique donne la même réponse ; un modèle à niveau stochastique non, parce qu’une marche aléatoire mélangée n’en est plus une et que la variance du niveau s’effondre.
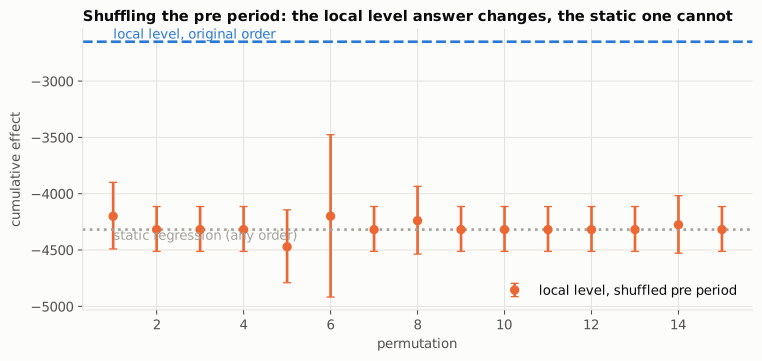
Sur 20 permutations, l’effet cumulé du niveau local converge vers la réponse statique et son intervalle étroit (largeur 518 contre 4 971 dans l’ordre original). L’intervalle plus large du niveau local est le prix de la dépendance sérielle ; l’intervalle étroit de la régression statique est ce qu’on obtient en faisant comme si les semaines étaient échangeables.
9. Comparaison avec le CausalImpact de Google#
Le modèle construit à la main est un cousin fréquentiste de CausalImpact : même espace d’états,
maximum de vraisemblance au lieu d’a priori et de MCMC. J’ai fait tourner tfcausalimpact, le
port TensorFlow Probability, sur le panel Volkswagen et sur des panels synthétiques.
| cas | méthode | effet cumulé, IC 95 % | largeur |
|---|---|---|---|
| VW, BMW + Allianz | construit à la main, MLE | −2 650 [−5 140 ; −169] | 4 971 |
| tfcausalimpact, a priori par défaut sur l’écart-type du niveau (0,01) | −3 355 [−4 427 ; −2 233] | 2 193 | |
| tfcausalimpact, a priori à 0,1 | −2 878 [−5 212 ; −428] | 4 784 |
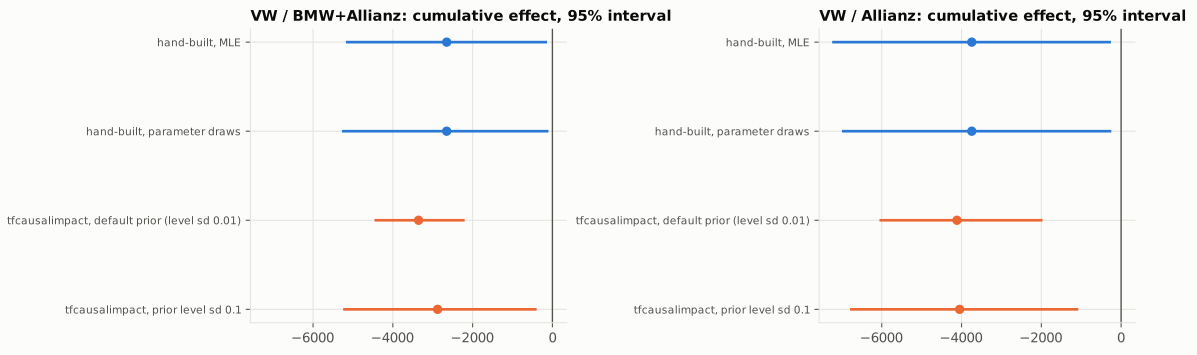
Mêmes données, même espace d’états, estimations ponctuelles chacune dans l’intervalle de l’autre, et un intervalle moitié moins large. L’a priori par défaut de CausalImpact sur l’écart-type du niveau est 0,01, en unités de la série standardisée ; le maximum de vraisemblance donne ici 0,085, huit fois plus. Un a priori serré garde le niveau presque déterministe, qui prévoit à 79 semaines avec une variance presque constante. En le desserrant à 0,1, l’intervalle s’ouvre jusqu’à celui construit à la main. L’intervalle étroit était l’a priori, pas les données. Ce n’est un défaut d’aucune implémentation, mais la largeur de l’intervalle sur un cas réel est un choix de modélisation, à rapporter comme tel. Sur une vérité connue, on peut demander qui couvre :
| 30 panels, hausse de 5 % | couverture | détection | largeur moyenne | RMSE | secondes par ajustement |
|---|---|---|---|---|---|
| construit à la main, MLE | 0,90 | 0,53 | 887 | 219 | 0,1 |
| tfcausalimpact, a priori par défaut | 0,77 | 0,80 | 494 | 262 | 15,7 |
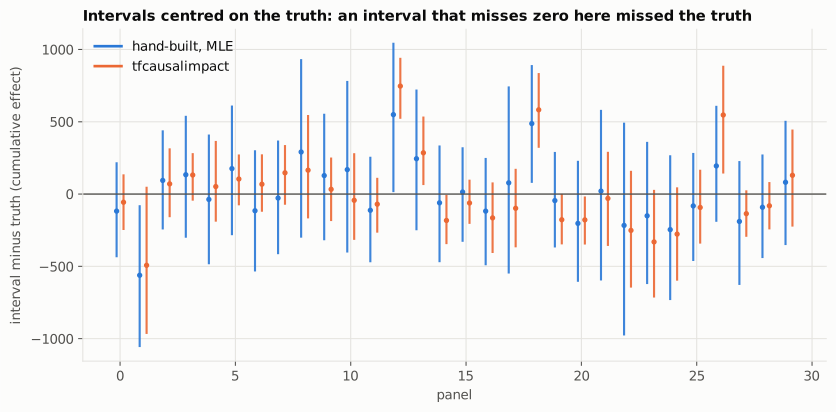
L’a priori par défaut achète un intervalle 45 % plus étroit et une détection plus élevée au prix de la couverture : 77 % contre 90 %. C’est un défaut raisonnable pour les séries marketing quotidiennes pour lesquelles la méthode a été conçue, et un mauvais défaut pour une série avec une grande marche aléatoire propre, comme un cours de bourse. Un balayage placebo le révélerait : son taux de faux positifs serait bien au-dessus de 5 %.
Ni « étroit » ni « bayésien » ne sont des synonymes de « calibré ». La couverture sur une vérité connue, ou un balayage placebo sur des données réelles, sont les seules preuves que j’ai trouvées, et c’est ce qui me ramène aux intervalles « plus étroits » de TASC. Un point pratique, enfin : 0,1 seconde par ajustement contre 12 à 16, ce qui compte pour les balayages et les études de Monte-Carlo.
10. Mesurer l’incrémentalité des promotions en continu#
Le troisième bloc du plan était une décision d’architecture, sans code : un moteur de promotions lance des campagnes sur des produits en magasin, et pour chaque campagne on veut l’effet causal sur les ventes par contrefactuel, parce que le métier n’acceptera pas un groupe témoin à chaque promotion. Trois points décident si le chiffre vaut quelque chose.
Sélection et intégrité des contrôles. Avec une part de la hausse cannibalisée sur un produit utilisé comme contrôle, l’effet est surestimé d’un quart et le placebo dans le temps reste vert dans 83 % des cas. Avant la campagne, les candidats contrôles viennent donc d’un registre de donneurs éligibles construit sur le graphe produit : même groupe de magasins et même saisonnalité que la cible, mais une catégorie différente et aucune arête de substitution, quelle que soit la qualité de l’ajustement, parce que le contrôle qui s’ajuste le mieux est souvent le substitut le plus proche. Le réservoir compte 10 à 20 donneurs, pour pouvoir en perdre. Après la campagne, le placebo dans l’espace en isolation leave-one-out signale les donneurs qui ont bougé : un effet propre négatif est une cannibalisation, un effet positif un halo, et l’effet est rapporté sur le réservoir conservé.
Surveiller l’hypothèse causale dans le temps. Le contrefactuel est inobservable. Quatre substituts, chacun lié à un mode de défaillance que le panel reproduit :
| Signal | Ce qu’il protège | Règle |
|---|---|---|
| ajustement pré-période du modèle déployé (R² à un pas, Ljung-Box, couverture de l’intervalle à un pas), par campagne | le modèle est de la bonne taille pour la série | couverture à un pas hors de [0,90 ; 0,98] ou Ljung-Box p < 0,01 bloque le rapport |
| placebo dans le temps glissant sur des produits jamais traités, même modèle, mêmes longueurs, chaque semaine | la calibration du design là où la vérité est zéro | part des intervalles placebo excluant zéro sur les 50 derniers runs au-dessus de 10 % (le panel a mesuré 11 % sur pré-périodes courtes) lève une alerte ; le taux sur panels propres est la référence |
| placebo dans l’espace sur chaque campagne | l’interférence | tout tour d’isolation au-delà du premier sur une cible déclenche une revue |
| stabilité de la relation donneur-cible : Chow sur les différences, dérive des coefficients entre campagnes successives de la même cible | la relation qui est extrapolée | p < 0,01 ou changement de signe d’un coefficient bloque le donneur |
Ce que cette surveillance ne peut pas voir, et le tableau de bord le dit : une relation qui casse à la date de la campagne. Seul le troisième point l’attrape.
Le garde-fou métier. L’effet estimé est un résidu de prévision. Il est relié à l’argent par une quantité observée plus tard : la marge incrémentale réalisée, réconciliée chaque mois contre la somme des marges contrefactuelles et incrémentales estimées. L’écart de réconciliation est une série temporelle : son niveau est bruité, sa dérive est l’alarme. Un écart qui croît dans une direction pendant trois mois signifie que les contrefactuels sont systématiquement faux, et c’est à cela que ressemble, vu de l’extérieur, une rupture de relation que rien d’autre ne voit. Deux ancres de plus : un vrai groupe témoin occasionnel sur une petite part des campagnes, comparé à l’effet contrefactuel ; et la somme des effets d’une même catégorie, qui ne peut pas dépasser longtemps sa croissance observée. Tant que l’écart n’est pas refermé pour une famille de produits, l’effet qui entre dans une décision est la borne basse de l’intervalle.
11. Ce que j’en retiens#
Ces constats valent pour les dispositifs étudiés ici : un panel semi-synthétique à cinq contrôles et 90 jours de post-période, et un panel de trois cours de bourse.
- Le contrefactuel est une prévision, et son incertitude est celle du modèle sur ce que fait la part inexpliquée dans le temps. Sur ces panels, seul un niveau qui peut dériver donne un intervalle à 95 % qui couvre à 95 %.
- Les estimateurs statiques sont précis et trop confiants : 80 % de faux positifs à effet nul. C’est l’argument le plus fort pour ne pas sauter le placebo.
- Le placebo dans le temps valide le modèle pré-intervention, et rien de ce qui commence à la date de l’intervention. Il est aveugle à un contrôle contaminé et à une rupture de relation.
- Le placebo dans l’espace est la vérification de l’interférence, avec une puissance modeste et une isolation leave-one-out nécessaire, parce qu’un donneur contaminé signale ses voisins.
- Une relation qui casse à la date de l’intervention n’est vue par aucune vérification sur les données. Choix des contrôles avant, réconciliation métier après : c’est le seul traitement que j’ai trouvé.
- Un placebo qui se déclenche n’invalide pas forcément le design. Je lis désormais un balayage contre son taux propre, pas une date contre 5 %.
- Sur Volkswagen, l’effet de l’avis de l’EPA est de −17 % à −27 % sur 79 semaines, selon le jeu de contrôles, placebo propre à douze fausses dates, BMW signalé comme contrôle douteux.
- La largeur de l’intervalle sur un cas réel est un choix de modélisation. L’a priori par défaut de CausalImpact donne un intervalle moitié moins large, qui couvre 77 % au lieu de 90 %.
Questions encore ouvertes. Je n’ai pas implémenté TASC, ni mesuré sa couverture. Une rampe et une impulsion restent à étudier à la place de l’effet en marche d’escalier, et le placebo dans l’espace n’a été mesuré que pour une taille de contamination. La surveillance de la partie 10 est un raisonnement, pas un système en production.
Reproduire et aller plus loin#
Le code, les cinq notebooks et les 22 tests sont dans le dépôt
gwils28/time_series_causal_statistics
(Python 3.13, versions verrouillées par uv). Chaque tableau de cet article sort d’une commande
cts synth, cts vw, cts study all ou cts tfci, avec des graines fixées ; les études de
Monte-Carlo prennent une quinzaine de minutes et le contrôle croisé une dizaine.
Sources
- Brodersen, Gallusser, Koehler, Remy et Scott, Inferring causal impact using Bayesian structural time-series models, The Annals of Applied Statistics, 9(1), 2015, et l’implémentation CausalImpact.
- Rho, Illick, Narasipura, Abadie, Hsu et Misra, Time-Aware Synthetic Control, arXiv, janvier 2026.
- Carlson et Shephard, When are time series predictions causal? The potential system and dynamic causal effects, arXiv, mars 2026.
- tfcausalimpact, port Python de CausalImpact sur TensorFlow Probability, et sa fixture de test pour le panel Volkswagen.