Temps de lecture : environ 23 minutes. Les formules sont toujours suivies de leur intuition : on peut les survoler sans perdre le fil.
Note de transparence. Ces travaux ont été menés à titre personnel, dans un but d’apprentissage, avec l’assistance d’une IA :
- pour le code, la relecture technique et méthodologique ;
- pour comprendre les outils et les méthodes mathématiques ;
- pour l’aide à la rédaction, la traduction et la correction du texte ;
- pour générer l’image de couverture de l’article.
Le choix du sujet, le protocole, la vérification des résultats et les conclusions sont les miens, et j’en assume les erreurs. Comment j’utilise l’IA
Cet article restitue ma veille active de la semaine 37 (septembre 2026). Je ne me suis pas contenté de lire : j’ai vérifié les sources, réécrit MinT de zéro, monté des expériences contrôlées, réconcilié les prévisions de consommation électrique des 12 régions françaises et testé un paquet de réconciliation bayésienne. Tout est reproductible, avec les versions épinglées, dans le dépôt W37_hierarchical_reconciliation.
En bref. La réconciliation garantit la cohérence, pas la précision ni la calibration. J’en ai trouvé quatre preuves :
- En théorie : un biais sur une seule prévision contamine toutes les autres.
- En probabiliste : un intervalle annoncé à 90 % au niveau total peut n’en couvrir que 76 %.
- Sur des données réelles : sur 119 jours de 2024, la méthode la plus simple (bottom-up) bat MinT.
- Sur des ventes au détail : 98 % des intervalles réconciliés par MinT commencent sous zéro.
1. Le problème : des prévisions qui ne s’additionnent pas#
Prenons une coopérative qui vend dans deux régions, chacune par deux canaux : la grande distribution (GMS) et la restauration (RHD). Cela fait 7 séries à prévoir : le total, 2 régions et 4 couples région × canal. Chaque série a son modèle, réglé au mieux. Mais personne n’a demandé aux modèles de se mettre d’accord.
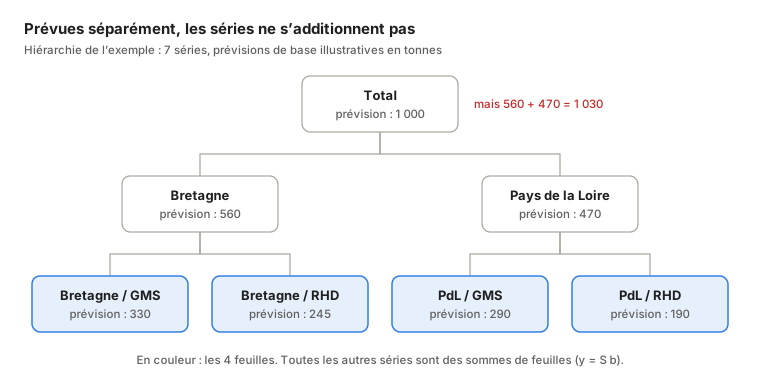
La structure se décrit par une matrice de sommation \(S\). Les séries du bas, les feuilles \(b_t\), déterminent tout le reste :
$$ y_t = S\,b_t, \qquad S = \begin{pmatrix} 1 & 1 & 1 & 1\\ 1 & 1 & 0 & 0\\ 0 & 0 & 1 & 1\\ 1 & 0 & 0 & 0\\ 0 & 1 & 0 & 0\\ 0 & 0 & 1 & 0\\ 0 & 0 & 0 & 1 \end{pmatrix} \begin{matrix}\leftarrow \text{total}\\ \leftarrow \text{Bretagne}\\ \leftarrow \text{Pays de la Loire}\\ \leftarrow \text{Bretagne / GMS}\\ \leftarrow \text{Bretagne / RHD}\\ \leftarrow \text{PdL / GMS}\\ \leftarrow \text{PdL / RHD}\end{matrix} $$Un vecteur de prévisions est cohérent s’il s’écrit \(S\,b\) pour un certain \(b\) : toutes les sommes tombent juste. Les prévisions de base \(\hat y\), produites série par série, ne le sont presque jamais.
Les deux réponses classiques jettent de l’information :
- le bottom-up additionne les feuilles et ignore les prévisions des agrégats, souvent plus stables ;
- le top-down répartit le total selon des proportions historiques et ignore ce que savent les modèles des feuilles. S’il calcule ses proportions sur un historique qui inclut la période de test, il fuit en plus de l’information du futur, sans que rien ne le signale dans les métriques.
La réconciliation optimale se propose d’utiliser toutes les prévisions à la fois.
2. MinT en cinq minutes : réconcilier, c’est projeter#
Le cadre#
On cherche une matrice \(G\) qui ramène les \(m\) prévisions de base à \(n_b\) feuilles, que l’on ré-additionne ensuite :
$$ \tilde y = S\,G\,\hat y . $$Deux conditions encadrent le choix de \(G\) :
| Condition | Formule | Ce qu’elle veut dire |
|---|---|---|
| préservation du non-biais | \(SGS = S\) | un vecteur déjà cohérent n’est pas modifié |
| variance de l’erreur réconciliée | \(\operatorname{Var}(y - \tilde y) = S G W G^\top S^\top\) | avec \(W = \operatorname{Var}(y - \hat y)\), la covariance des erreurs de base |
MinT (Minimum Trace, Wickramasuriya, Athanasopoulos et Hyndman, 2019) minimise la trace de cette variance sous la contrainte \(SGS = S\). La solution a une forme fermée :
$$ G = \left(S^\top W^{-1} S\right)^{-1} S^\top W^{-1}, \qquad P = S\,G . $$L’intuition géométrique#
\(P\) est une projection (\(P^2 = P\)). Les vecteurs cohérents forment un sous-espace de dimension \(n_b\) dans \(\mathbb{R}^m\), et réconcilier revient à ramener \(\hat y\) sur ce sous-espace. Toute la question est : dans quelle direction ?
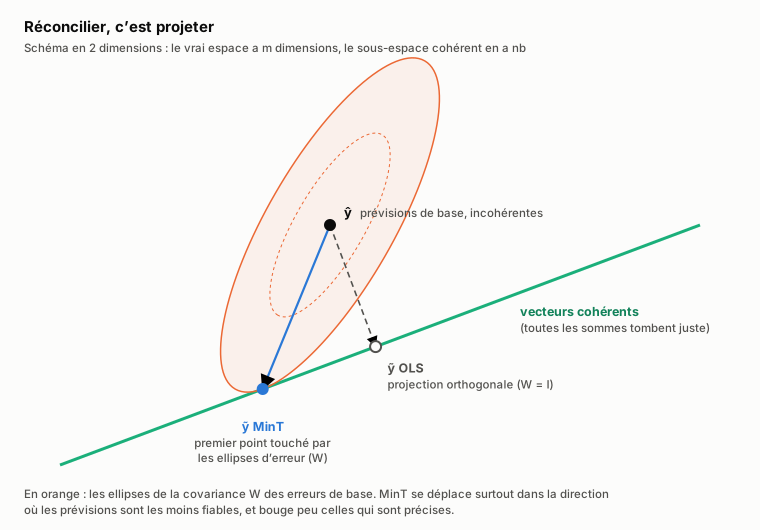
- OLS (\(W = I\)) projette orthogonalement : toutes les séries sont jugées aussi fiables.
- MinT projette selon \(W^{-1}\). Il retient le point cohérent qui est le plus plausible compte tenu de la forme des erreurs : il bouge beaucoup les séries mal prévues et peu les autres.
- Le bottom-up est aussi une projection, avec \(G = [\,0 \mid I\,]\) : il ne bouge que les agrégats.
| Méthode | Matrice \(W\) utilisée | Ce qu’elle suppose |
|---|---|---|
| bottom-up | — (\(G = [0 \mid I]\)) | les agrégats n’apportent rien |
| OLS | \(I\) | toutes les erreurs se valent |
| WLS struct | \(\operatorname{diag}(S\mathbf{1})\) | variance proportionnelle au nombre de feuilles agrégées |
| WLS var | \(\operatorname{diag}(\hat W)\) | variances propres, pas de corrélations |
| MinT shrink | \(\lambda D + (1 - \lambda)\hat W\) | variances et corrélations, régularisées |
Le détail qui comptera plus loin#
\(W\) est inconnue. En pratique, on l’estime sur les résidus in-sample des modèles de base, puis on la régularise par le shrinkage de Schäfer et Strimmer : on tire les corrélations vers zéro avec une intensité \(\lambda \in [0, 1]\) estimée sur les données. Gardez ce point en tête : c’est lui qui fera perdre MinT sur les données réelles (partie 6).
3. Ce que dit la veille 2026#
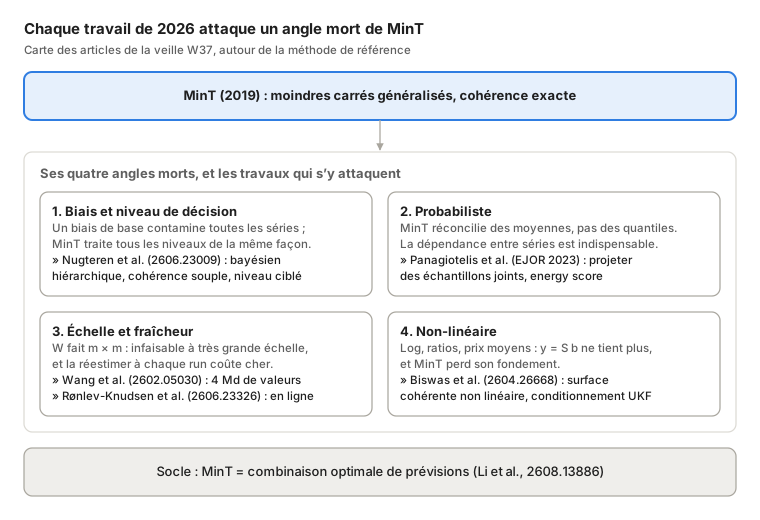
J’ai lu six travaux, choisis pour couvrir les angles morts de MinT. Pour chacun, j’ai confronté ce qu’on en disait à son résumé officiel. Le plan de lecture en sortait parfois enjolivé.
| Travail | Ce qu’il apporte | Ce que la vérification a corrigé |
|---|---|---|
| Li, Chen, Taylor, Mao — A Forecast Combination Framework for Hierarchical and Grouped Time Series Reconciliation (2608.13886) | Les poids de combinaison optimaux retrouvent exactement MinT. Quarante ans de littérature sur la combinaison de prévisions (shrinkage, pénalités, positivité) deviennent réutilisables. | — |
| Rønlev-Knudsen, Madsen, Møller — Online forecast reconciliation using linear models (2606.23326) | La réconciliation comme régression régularisée, mise à jour récursivement : plus besoin de réestimer \(W\) à chaque run. | Le cas d’étude est une hiérarchie temporelle, pas géographique. À valider avant de transposer. |
| Nugteren, Abolghasemi, Mengersen, Drovandi — Hierarchical Bayes meets hierarchical forecasting (2606.23009) | Un modèle bayésien qui cible le niveau qui porte la décision. | La cohérence y est souple (pénalisée), pas exacte. |
| Wang, Johnson, Klee, Malloy — Billions-Scale Forecast Reconciliation (2602.05030) | Réconciliation à plus de quatre milliards de valeurs ; moindres carrés et répartition par parts coïncident sous conditions. | — |
| Panagiotelis, Gamakumara, Athanasopoulos, Hyndman — Probabilistic forecast reconciliation (EJOR, 2023) | La bonne définition de la réconciliation d’une distribution, évaluée par energy score et variogram score. | — |
| Biswas, Zambon, Nespoli, Corani — Nonlinear Probabilistic Forecast Reconciliation (2604.26668) | Ce qui se passe quand \(y = Sb\) ne tient plus : logs, ratios, prix moyens. | — |
La vérification s’est limitée aux résumés et aux pages officielles, pas aux PDF complets.
Trois tendances s’en dégagent :
- La réconciliation devient un estimateur, plus un post-traitement. Vue comme combinaison de prévisions ou comme régression régularisée, elle se régularise, se teste et se défend devant une revue d’architecture.
- Les objections d’échelle tombent. Quatre milliards de valeurs d’un côté, une estimation récursive de l’autre.
- Le front ouvert est le probabiliste et le non-linéaire. C’est précisément là que MinT ponctuel ne dit plus rien. La partie 5 le montre.
4. Réécrire MinT soi-même#
Appeler MinTrace(method="mint_shrink") prend une ligne. Mais tant qu’on n’a pas écrit la
formule soi-même, on ne sait pas expliquer un résultat bizarre. J’ai donc réimplémenté MinT shrink
en NumPy, en m’interdisant de lire le code de
HierarchicalForecast avant d’avoir figé le mien.
Voici le cœur, condensé :
import numpy as np

def mint_shrink(E, S):
    """E : résidus in-sample (T × m), S : matrice de sommation (m × nb). Renvoie P = SG."""
    T, m = E.shape
    W1 = E.T @ E / T                          # covariance empirique
    Z = E / np.sqrt(np.diag(W1))              # résidus standardisés
    R = Z.T @ Z / T                           # corrélations
    w = Z[:, :, None] * Z[:, None, :]         # T × m × m : naïf, voir plus bas
    var_r = T / (T - 1) ** 3 * ((w - R) ** 2).sum(axis=0)
    off = ~np.eye(m, dtype=bool)
    lam = np.clip(var_r[off].sum() / (R[off] ** 2).sum(), 0, 1)   # λ de Schäfer–Strimmer
    W = lam * np.diag(np.diag(W1)) + (1 - lam) * W1
    WiS = np.linalg.solve(W, S)                       # W⁻¹S, sans inverser W
    G = np.linalg.solve(S.T @ WiS, WiS.T)             # (S'W⁻¹S)⁻¹ S'W⁻¹
    return S @ G
Sur une hiérarchie synthétique (2 régions × 2 canaux, 80 trimestres, modèles AutoETS), les
contrôles passent :
| Contrôle | Seuil | Mesuré |
|---|---|---|
| \(P^2 = P\) et \(SGS = S\) | < 1e-12 | 2,2e-16 |
| incohérence des prévisions réconciliées | précision machine | 5,7e-14 |
| écart relatif à HierarchicalForecast 1.5.1 | < 1e-3 | 1,07e-5 |
| écart non nul | > 0 | oui |
Le dernier contrôle est volontaire : un écart exactement nul aurait voulu dire que j’avais recopié leur code. Ce petit écart résiduel m’a appris trois choses.
Leçon 1 : un même nom de méthode recouvre plusieurs estimateurs#
Le plan de veille attribuait l’écart à une différence dans le calcul de \(\lambda\). C’est
faux : les deux \(\lambda\) sont égaux à 2e-5 près. Environ 99,8 % de l’écart vient de la
covariance de base. La bibliothèque centre les résidus et divise par \(T - 1\) (np.cov), alors
que ma version prend \(E^\top E / T\). Avec la même convention, l’écart tombe à 3e-6.
Conséquence pratique : mint_shrink désigne au moins trois choix d’implémentation (centrage,
ddof, variante de \(\lambda\)) qui changent le chiffre publié. Si deux équipes comparent leurs
runs, il faut épingler la version et documenter l’estimateur.
Leçon 2 : le shrinkage est une condition d’existence#
Même avec 72 observations pour 6 séries, la covariance empirique est mal conditionnée (conditionnement ≈ 3·10⁴). Le résidu d’un agrégat est presque la somme des résidus de ses feuilles, donc les colonnes de \(E\) sont quasi colinéaires. Le shrinkage ramène le conditionnement à ≈ 23.
Avec plus de séries que d’observations (\(m > T\)), c’est pire : \(\hat W\) est de rang \(T\), donc singulière. Avec \(T = 4\) et \(m = 6\), son conditionnement atteint 1,7·10¹⁷. Le shrinkage choisit alors seul \(\lambda = 0{,}907\) et ramène le conditionnement à 10. Le shrinkage n’est pas un confort : sans lui, MinT n’existe pas sur un catalogue réel. 40 000 références sur trois ans d’historique hebdomadaire, c’est \(m/T \approx 250\).
Leçon 3 : le mur est aussi en mémoire#
La ligne marquée « naïf » construit un tenseur \(T \times m \times m\) : 31 Go pour 5 000 séries. Ma première version a fait tuer le noyau Jupyter par le système. Or \(\lambda\) ne dépend que de sommes hors diagonale, qu’on peut calculer à partir de la matrice de Gram \(T \times T\). La mémoire passe de \(O(T m^2)\) à \(O(T^2 + Tm)\), soit 0,6 Go, pour un résultat identique à 1e-10 près. Au-delà, c’est \(W\) elle-même qu’il ne faut plus former. Une diagonale plus une matrice de rang \(T\) s’inverse par l’identité de Woodbury, sans jamais construire de matrice \(m \times m\).
5. Trois endroits où MinT casse#
MinT est optimal sous hypothèses : prévisions de base sans biais, \(W\) connue, contraintes linéaires, quantités continues. J’ai monté une expérience contrôlée pour chacune de ces hypothèses. Chaque fois, j’ai cherché où elle cède.
5.1 MinT propage le biais#
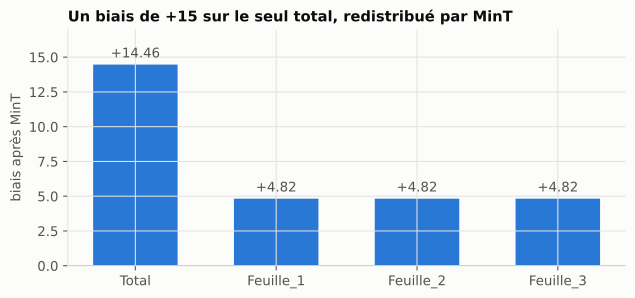
La condition \(SGS = S\) préserve l’absence de biais, elle ne la crée pas. Le contre-exemple tient en quatre séries : un total et trois feuilles. Les prévisions sont exactes partout, sauf un biais de +15 sur le total. \(W\) fait 9 fois plus confiance au total qu’à chaque feuille.
| Série | Vérité | Base | Bottom-up | MinT | Erreur MinT |
|---|---|---|---|---|---|
| Total | 60 | 75 | 60 | 74,46 | 14,46 |
| Feuille 1 | 10 | 10 | 10 | 14,82 | 4,82 |
| Feuille 2 | 20 | 20 | 20 | 24,82 | 4,82 |
| Feuille 3 | 30 | 30 | 30 | 34,82 | 4,82 |
Le bottom-up ignore le total et ne voit rien. MinT, qui lui fait confiance, injecte le biais dans chaque feuille. Comme la réconciliation est linéaire, le biais réconcilié vaut \(P \times\) le biais de base : il se répand selon une colonne de \(P\).
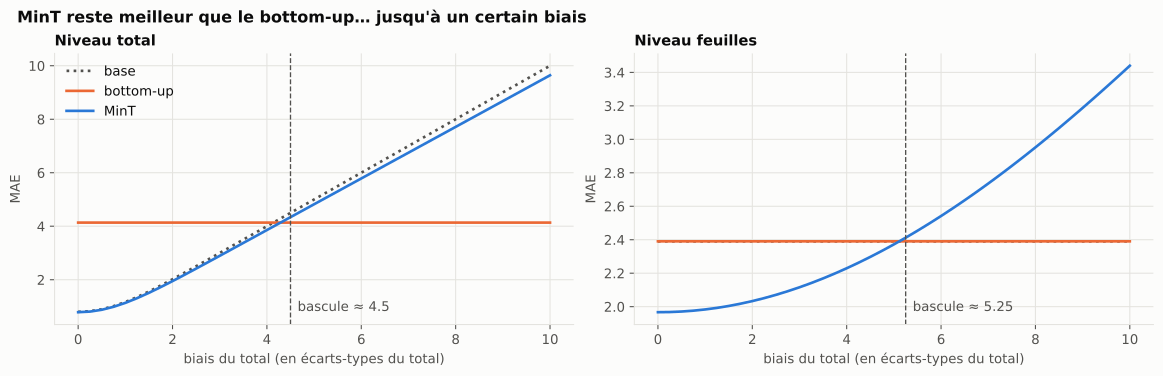
Ce n’est pas tout ou rien : il existe un seuil. Par simulation (20 000 tirages), MinT reste meilleur que le bottom-up tant que le biais du total reste sous ≈ 4,5. Au-delà, il devient pire au total ; au-delà de ≈ 5,25, il est pire aussi aux feuilles, donc à tous les niveaux.
5.2 MinT réconcilie des moyennes, pas des quantiles#
C’est le cœur de la semaine. Le gestionnaire de stock ne décide pas sur une moyenne. Il décide sur un quantile : le stock qui couvre la demande 90 % du temps. Or le quantile d’une somme n’est pas la somme des quantiles.
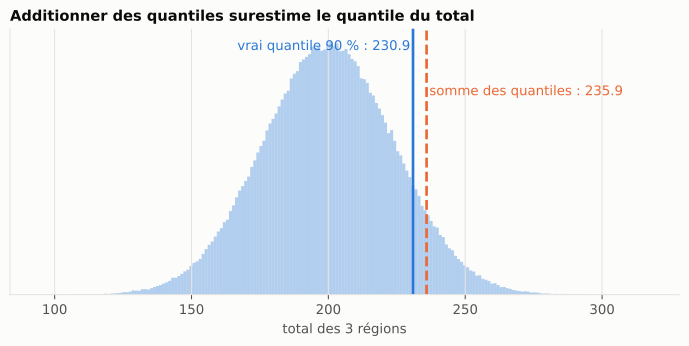
Conséquence : aucun vecteur de quantiles n’est cohérent. La cohérence est une propriété de la loi jointe, pas des marginales.
L’expérience, entièrement simulée pour connaître la vérité : un total et trois régions gaussiennes, corrélées à \(\rho = 0{,}6\) (la météo les fait bouger ensemble). Chaque modèle de base est parfait sur sa propre série. Les moyennes sont déjà cohérentes, donc tout ce qu’on observe est un pur effet « quantile ». On compare trois façons d’obtenir des quantiles à 90 % réconciliés :
- A. Appliquer \(P\) directement aux quantiles. C’est l’erreur la plus courante.
- B. Tirer des échantillons de chaque série indépendamment, projeter chaque échantillon, puis lire les quantiles.
- C. Pareil, mais avec des échantillons joints, qui respectent la dépendance entre séries.
| Série | Couverture A | Couverture B | Couverture C |
|---|---|---|---|
| Total | 0,922 | 0,764 | 0,900 |
| Région 1 | 0,887 | 0,878 | 0,900 |
| Région 2 | 0,890 | 0,888 | 0,899 |
| Région 3 | 0,893 | 0,894 | 0,901 |
Cible : 0,900. 400 000 tirages, graine fixe.
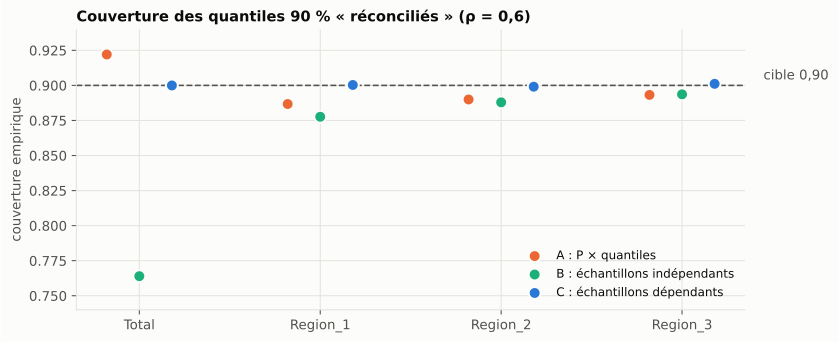
Comment lire ce tableau :
- A est fausse dans les deux sens à la fois. Elle sur-couvre au total et sous-couvre dans les régions. Aucun facteur global ne peut la corriger. Le vecteur obtenu somme parfaitement, mais il n’est le quantile de rien.
- B, qui a l’air rigoureuse, est la pire : 76 % de couverture au total pour 90 % annoncés. Projeter des échantillons est la bonne mécanique. Mais des tirages indépendants effacent la dépendance, et la variance de la somme est massivement sous-estimée.
- C est calibrée partout. Sa seule différence avec B est la structure de dépendance.
Le balayage en corrélation rend le résultat difficile à contester :
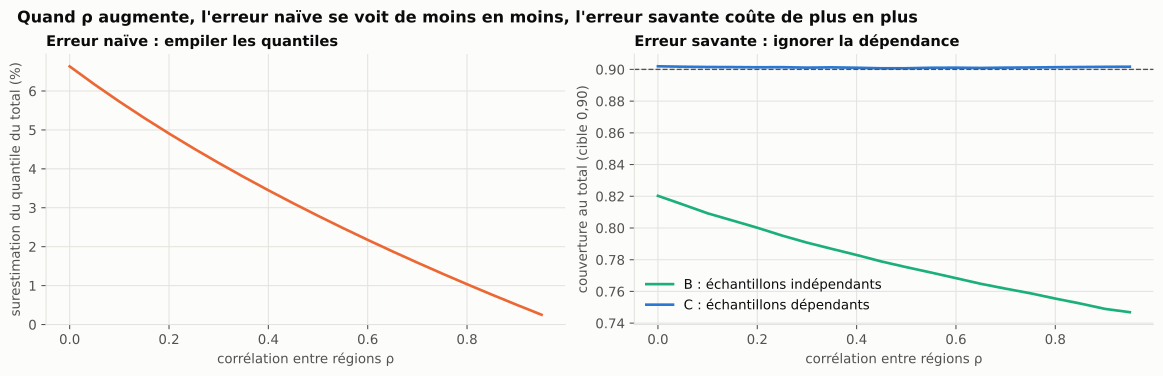
| \(\rho\) | Écart « somme des q90 » / « q90 de la somme » | Couverture B au total |
|---|---|---|
| 0,0 | +6,6 % | 0,816 |
| 0,3 | +4,2 % | 0,787 |
| 0,6 | +2,2 % | 0,764 |
| 0,9 | +0,5 % | 0,746 |
En pratique, on ne connaît pas la vraie covariance. La solution est le bootstrap joint des
résidus in-sample : on rééchantillonne des instants, et toutes les séries sont tirées au même
instant. On retrouve 0,902 au total. Le bootstrap série par série reproduit l’erreur de B (0,760).
Dans HierarchicalForecast, ce sont les méthodes Bootstrap et PERMBU.
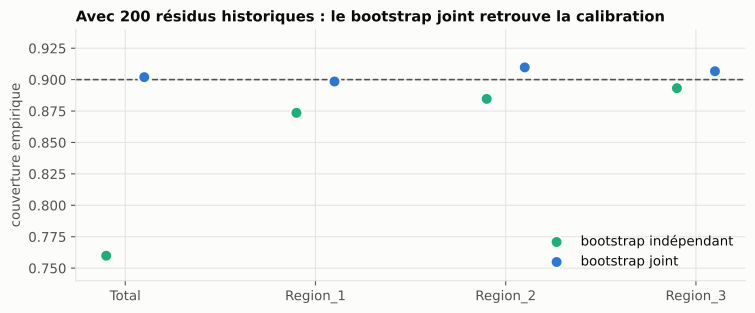
Une règle simple en découle : même instant, toutes les séries. Un bootstrap qui tire des résidus à des dates différentes selon les séries (historiques de longueurs inégales, trous) est une méthode B déguisée.
5.3 MinT ne connaît pas le zéro#
Troisième hypothèse implicite : les quantités sont continues et symétriques. Sur des ventes d’articles à rotation lente (souvent 0, parfois un pic), une gaussienne de la bonne variance déborde largement sous zéro.
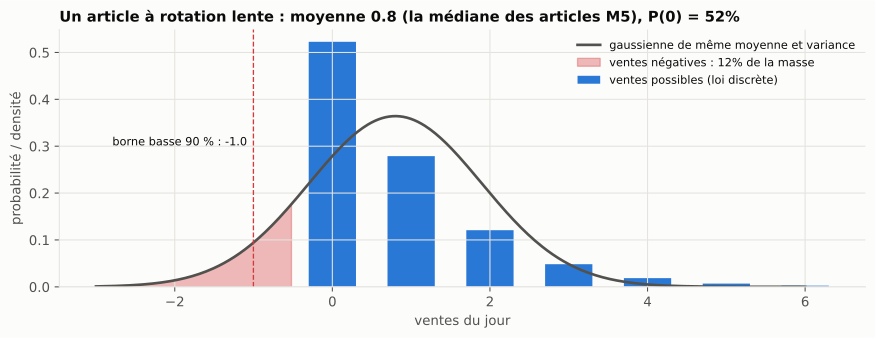
Je l’ai mesuré sur un magasin du jeu M5 (Walmart, magasin CA_1 : 3 049 articles et 11 agrégats, prévision à un jour), en comparant MinT gaussien à BayesReconPy. Ce paquet ne projette pas : il conditionne. Il garde la loi jointe des articles sur les entiers positifs et la repondère par ce que disent les prévisions des agrégats (règle de Bayes).
| MinT gaussien | bottom-up | MixCond | TD-cond | |
|---|---|---|---|---|
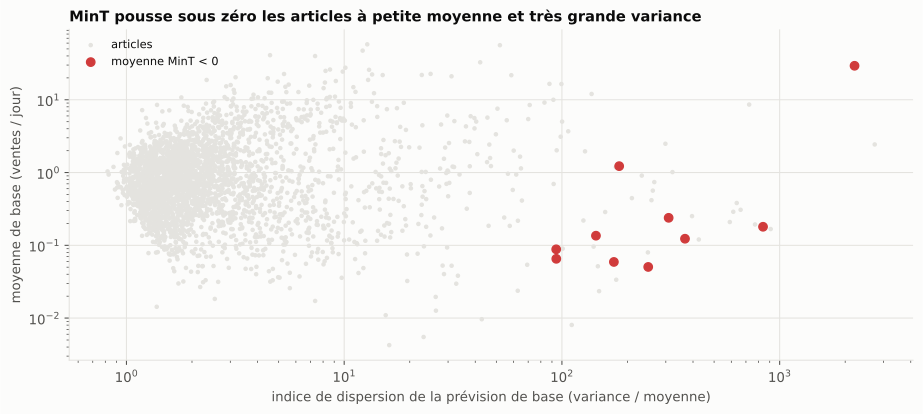
| articles à moyenne négative | 11 | 0 | 0 | 0 |
| articles dont la borne à 90 % est < 0 | 2 992 (98 %) | 0 | 0 | 0 |
| RPS articles (plus bas = mieux) | 0,819 | 0,676 | 0,674 | 0,669 |
| MIS agrégats (plus bas = mieux) | 1 825 | 2 330 | 2 312 | 444 |
Le chiffre qui compte dépend de la décision. Pour une décision sur la moyenne, 0,36 % des prévisions sont négatives. Pour un niveau de service, c’est 98 %. Le mécanisme est lisible : avec une \(W\) diagonale, l’ajustement de chaque article est proportionnel à sa variance. Les articles « presque toujours 0, parfois un gros pic » absorbent donc l’essentiel de la correction et passent sous zéro.
Deux observations de plus :
- Le bottom-up et MixCond rendent les intervalles des agrégats cinq fois moins bons. Supposer 3 049 articles indépendants donne un total beaucoup trop étroit : c’est la méthode B de la section précédente, à grande échelle. TD-cond, qui part des agrégats, évite ce piège et reste le plus précis aux deux niveaux.
- Mes chiffres reproduisent la vignette R officielle du paquet
bayesReconsur le même magasin, avec un écart médian de 0,15 point de skill score.
pulp<4). Sa licence est
contradictoire : MIT dans les métadonnées, LGPL-3.0 dans le dépôt. Enfin, reconc_td_cond
modifie ses entrées en place. C’est un excellent outil spécialisé, mais il faut en connaître les
conditions d’emploi.6. Sur des données réelles : douze régions, une France#
Les expériences précédentes sont contrôlées. Restait à confronter MinT à des données réelles. J’ai pris la consommation électrique des 12 régions métropolitaines (éCO2mix, RTE, via ODRÉ, Licence Ouverte v2.0). L’objectif métier : livrer des prévisions horaires à J+1 dont la somme des régions reproduit exactement le total France.
Vérifier les données avant de prévoir#
Trois découvertes ont précédé la première prévision :
- La Nouvelle-Aquitaine s’arrête fin 2024, alors que les autres régions continuent. Depuis 2025, la somme des régions n’est plus le total France. Le protocole se limite donc à 2013–2024.
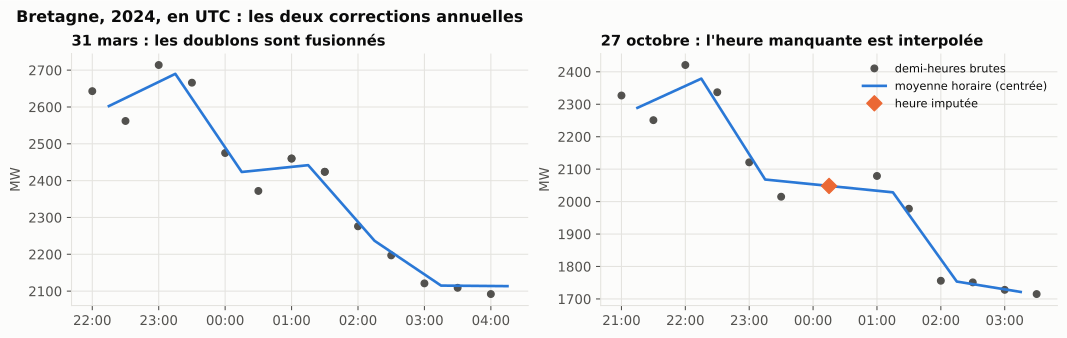
- La source a un défaut de changement d’heure, chaque année et dans chaque région : deux
doublons fin mars, une heure manquante fin octobre. Une ligne absente fausse un total sans
lever la moindre erreur, ce qui est plus dangereux qu’un
NaN. - Le total officiel n’est pas toujours la somme des régions. L’écart dépasse 200 MW en octobre 2016. Un test année par année montre qu’il reste sous 6 MW (l’arrondi) de 2014 à 2024, hors 2016 : sur la période réellement utilisée, réconcilier vers ce total a donc un sens.
Le protocole, fixé avant les résultats#
- Pas horaire : moyenne des demi-heures, en UTC. Des MW restent des MW, et aucun jour ne compte 23 ou 25 heures.
- Modèles de base :
SeasonalNaive(168)comme plancher,MSTLà double saisonnalité (24 h et 168 h) comme modèle réconcilié. - Fenêtre : 52 semaines glissantes, strictement antérieures à chaque origine.
- Méthodes comparées : bottom-up, OLS, WLS struct, WLS var, MinT shrink.
- Métrique : MASE par niveau (France, puis moyenne des régions), jamais en moyenne globale.
Le plan initial prévoyait 4 origines : quatre mardis de novembre 2024. J’ai ajouté une étude de robustesse sur 119 origines, une tous les trois jours sur l’année 2024.
Le classement s’inverse#
La cohérence est garantie : l’incohérence maximale est exactement 0 MW après réconciliation, contre 672 MW pour les prévisions de base. Mais la précision raconte une autre histoire selon le nombre d’origines :
| MASE moyen, 119 origines | France | Régions |
|---|---|---|
| SeasonalNaive (plancher) | 0,947 | 0,939 |
| bottom-up | 0,352 | 0,427 |
| WLS var | 0,356 | 0,430 |
| WLS struct | 0,358 | 0,432 |
| OLS | 0,366 | 0,439 |
| MinT shrink | 0,370 | 0,439 |
Sur 4 origines, MinT semblait gagner au niveau régional (−2,2 %), sans significativité. Sur 119 origines, le bottom-up est la meilleure méthode aux deux niveaux, et MinT shrink fait moins bien que lui sur les 13 séries, sans exception. Les quatre mardis étaient tombés du côté favorable d’une distribution très étalée. Après correction de Holm, la preuve reste modérée (p ≈ 0,05), mais le signe est constant. Quatre origines ne suffisent pas à classer des méthodes.
La cause : une hypothèse cachée de mint_shrink#
MinT suppose que la covariance estimée \(W\) ressemble à celle des vraies erreurs de prévision. J’ai testé cette hypothèse directement. Les résidus in-sample de MSTL sont des restes de lissage, corrélés à 0,11 en moyenne entre régions. Les vraies erreurs hors échantillon le sont à 0,56 (intervalle bootstrap [0,45 ; 0,65]). MinT réconcilie donc avec une carte des erreurs fausse.
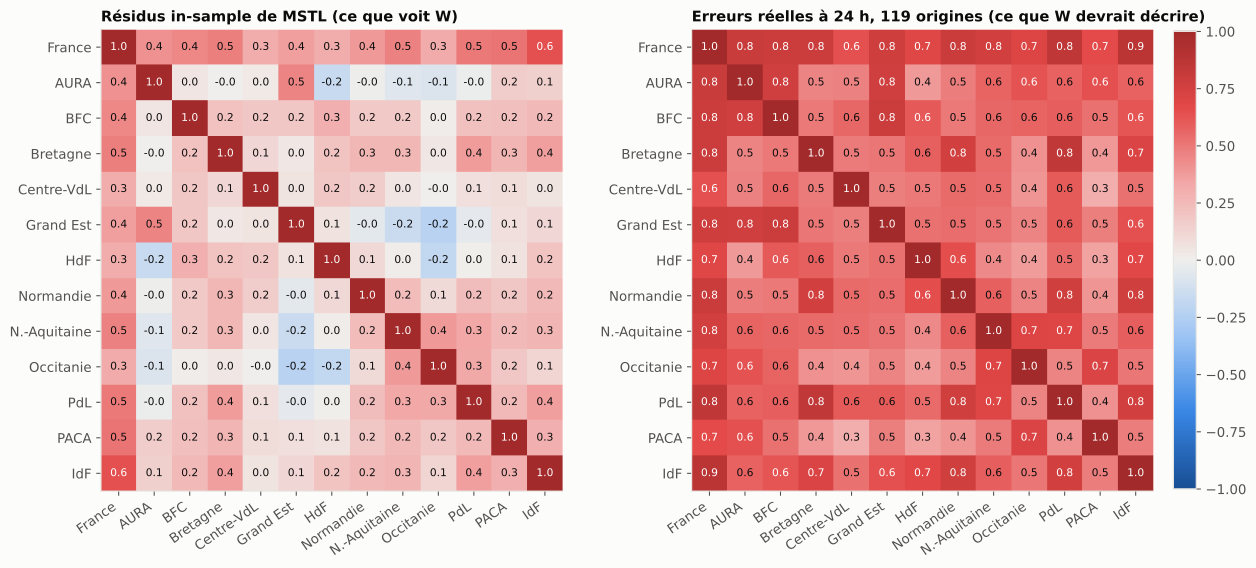
Pour isoler la cause, j’ai monté une expérience contrôlée. Tout reste identique, sauf \(W\), que j’estime sur les erreurs hors échantillon des origines passées, donc toujours sans fuite.
| 99 origines | MASE régional vs bottom-up | p (Wilcoxon) |
|---|---|---|
| MinT shrink, \(W\) in-sample | +2,6 % | 0,017 |
| MinT, \(W\) estimée sur erreurs passées | −0,1 % | 0,83 |
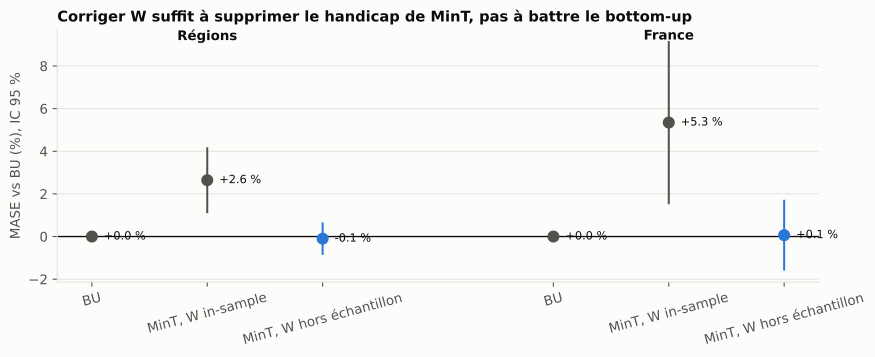
Corriger \(W\) supprime le handicap, mais ne fait pas gagner MinT. C’est plausible : les erreurs régionales sont fortement corrélées et de même signe (une vague de froid touche tout le monde), et il n’y a donc pas d’information croisée à exploiter.
Ma recommandation sur ce cas :
- Livrer le bottom-up. Il remplit l’objectif (cohérence exacte), il est le plus précis ici, et il s’explique en une phrase : « le national est la somme des régions ».
- Ne pas utiliser
mint_shrinkavec les résidus in-sample d’un modèle de lissage. Si MinT est nécessaire, estimer \(W\) sur des erreurs de backtest glissant. - Investir dans les modèles de base (température, jours fériés). Les plus grosses erreurs sont communes à toutes les régions, et aucune réconciliation ne les rattrape.
7. En production : où vit la réconciliation ?#
Dernière question, d’architecture : la réconciliation doit-elle être un job batch, une étape dans l’API, une vue SQL ou un estimateur mis à jour en ligne ? J’ai retenu un job batch matérialisé avec un contrôle qualité bloquant. Les raisons tiennent dans un schéma :
flowchart TD
    H[Historique et covariables] --> B["1. Prévisions de base
un modèle par série → ŷ incohérent"]
    B -->|ŷ + résidus du train| R["2. Réconciliation
P = S(S'W⁻¹S)⁻¹S'W⁻¹"]
    S["S versionnée + empreinte"] --> R
    R --> Q(["3. Contrôle qualité
cohérence · négatifs · MASE par niveau"])
    Q -->|échec| X[Publication bloquée + alerte]
    Q -->|succès| T[("Table forecast_reconciled
artefact immuable : run_id, empreinte de S, version de W")]
    T --> A["API /forecast?level=
lecture seule"]
Le point non négociable : l’API ne réconcilie jamais à la volée. Sinon deux appels simultanés sur deux niveaux peuvent renvoyer des chiffres qui ne somment pas, c’est-à-dire exactement le problème qu’on cherchait à supprimer. La cohérence est une propriété de l’artefact, pas de la requête.
| Option | Pour | Contre | |
|---|---|---|---|
| Batch matérialisé | cohérence par construction, auditable | latence de rafraîchissement | ✅ retenu |
| À la volée dans l’API | toujours à jour | cohérence non garantie entre appels | ❌ |
| Vue SQL | zéro infrastructure | MinT en SQL est ingérable, on retombe sur du bottom-up déguisé | ❌ |
| Estimation récursive en ligne | \(W\) suit les changements de régime | état mutable à versionner et à rejouer | ⏳ plus tard |
Écrire ce contrat en code exécutable, avec des tests où chaque règle échoue, a corrigé quatre choses dans la version sur papier :
- Le repli vers une méthode plus simple ne doit pas se déclencher quand \(m > T\). C’est précisément le cas pour lequel le shrinkage existe (leçon 2). Il se déclenche sur le conditionnement mesuré de \(W\).
- Une tolérance absolue de cohérence n’a pas le même sens sur 10 MW et sur 50 GW. J’ai ajouté une tolérance relative.
- La règle « pas de dégradation du MASE » s’applique niveau par niveau, jamais en moyenne. Sinon, un gain au national masque une perte au niveau de décision.
- L’empreinte de \(S\) couvre aussi les libellés. Une feuille renommée change la hiérarchie sans changer la matrice.
reconciler:
  method: mint_shrink
  fallback: wls_struct          # déclenché par cond(W) mesuré, pas par m > T
  covariance_window: 104        # semaines, strictement antérieures à l'origine
quality_gate:
  coherence_tol_abs: 1e-6
  coherence_tol_rel: 1e-9       # le bruit flottant croît avec les valeurs
  max_negative_share: 0.001     # MinT gaussien sur M5 : 0,0036 → bloqué
  compare_to_baseline: bottom_up  # échec si le MASE se dégrade de plus de 2 % à UN niveau
  fail_action: block_publish
8. Ce que j’en retiens#
- La réconciliation vend de la cohérence, pas de la précision. Le gain de précision est fréquent, jamais garanti, et il dépend d’hypothèses qu’on peut tester.
- Toujours comparer au bottom-up, niveau par niveau. Battre des prévisions incohérentes ne prouve rien, et une moyenne globale cache le niveau qui porte la décision.
- \(W\) est le maillon faible. Estimée sur des résidus in-sample, elle peut décrire des erreurs qui n’existent pas. Le shrinkage est indispensable, mais il ne corrige pas une mauvaise source.
- Ne jamais réconcilier des quantiles. Réconcilier une distribution, c’est projeter des échantillons joints. Des tirages indépendants donnent un intervalle à 90 % qui en couvre 76.
- Les comptages exigent d’autres outils. Une gaussienne n’a rien à faire près de zéro. Le conditionnement (TD-cond) est à la fois cohérent, positif et plus précis.
- Vérifier avant de croire : les données (heure d’été, région manquante), les sources (ce que dit vraiment le résumé), les paquets (installation, licence) et les classements (4 origines contre 119).
La suite. Tout ce qui précède s’effondre si \(W\) est estimée sur des résidus contaminés, si la hiérarchie change sans prévenir ou si une feuille a un trou. La veille de la semaine 38 porte donc sur la construction de variables temporelles sans fuite : fenêtres glissantes correctes, données « telles que connues à la date », référentiels qui changent dans le temps. Le fil rouge : ce n’est pas le modèle qui fuit, c’est la jointure.
Reproduire et aller plus loin#
Le code, les 14 notebooks et les 88 tests sont dans le dépôt
gwils28/W37_hierarchical_reconciliation
(Python 3.12, HierarchicalForecast 1.5.1, statsforecast 2.1.1, BayesReconPy 0.5.0, versions
verrouillées par uv). Chaque chiffre de cet article sort d’une commande uv run w37 ….
Sources
- Wickramasuriya, Athanasopoulos, Hyndman, Optimal forecast reconciliation for hierarchical and grouped time series through trace minimization, JASA, 2019.
- Li, Chen, Taylor, Mao, A Forecast Combination Framework for Hierarchical and Grouped Time Series Reconciliation, arXiv, 2026.
- Rønlev-Knudsen, Madsen, Møller, Online forecast reconciliation using linear models, arXiv, 2026.
- Nugteren, Abolghasemi, Mengersen, Drovandi, Hierarchical Bayes meets hierarchical forecasting, arXiv, 2026.
- Wang, Johnson, Klee, Malloy, Billions-Scale Forecast Reconciliation, arXiv, 2026.
- Panagiotelis, Gamakumara, Athanasopoulos, Hyndman, Probabilistic forecast reconciliation: properties, evaluation and score optimisation, EJOR 306(2), 2023.
- Biswas, Zambon, Nespoli, Corani, Nonlinear Probabilistic Forecast Reconciliation, arXiv, 2026.
- Schäfer, Strimmer, A shrinkage approach to large-scale covariance matrix estimation, SAGMB, 2005.
- Biswas et al., BayesReconPy, JOSS 10(111), 2025.
- Bibliographie vivante : awesome-forecast-reconciliation.
- Données : éCO2mix régional, Open Data Réseaux Énergies (ODRÉ), RTE, Licence Ouverte v2.0 ; M5 Forecasting.