Temps de lecture : environ 30 minutes. Les formules sont suivies de leur intuition : on peut les survoler sans perdre le fil. Le dépôt est en anglais, ses figures aussi.
Note de transparence. Ces travaux ont été menés à titre personnel, dans un but d’apprentissage, avec l’assistance d’une IA :
- pour le code, la relecture technique et méthodologique ;
- pour comprendre les outils et les méthodes mathématiques ;
- pour l’aide à la rédaction, la traduction et la correction du texte ;
- pour générer l’image de couverture de l’article.
Le choix du sujet, le protocole, la vérification des résultats et les conclusions sont les miens, et j’en assume les erreurs. Comment j’utilise l’IA
Cet article restitue deux semaines de veille active (du 2 au 15 août 2026) sur les modèles de fondation pour séries temporelles, abrégés TSFM (time series foundation models). Le plan tenait en quatre blocs : trois ressources récentes à lire à la source, un banc de backtest opposant un TSFM utilisé tel quel à des modèles statistiques solides, une décision d’architecture pour le « routeur de complexité » d’un article de mai 2026, et l’article fondateur du MASE à relire. Son critère de réussite : dire en une phrase sur quel horizon et quel régime le TSFM gagne ou perd, en s’appuyant sur la couverture des intervalles et pas seulement sur l’erreur moyenne. Tout est reproductible dans le dépôt W25_tsfm_viability.
En bref. Les principaux résultats, avec leur périmètre :
- Sur la charge française de 2019, Chronos-Bolt base bat le modèle de référence à chaque pas d’horizon et chaque type de jour ordinaire, sans avoir jamais vu la série. Contre le spécialiste le plus solide (MSTL), l’écart est plus modeste : 15 % d’erreur en moins pour Bolt base, 24 % pour Chronos-2.
- L’intervalle « à 90 % » de Chronos-Bolt est son intervalle à 80 %, par construction. Une réparation conforme, à partir de ses propres erreurs passées, le ramène à 0,902.
- Les jours fériés sont l’endroit où le zero-shot perd : son intervalle à 90 % y couvre 37 % des heures. Avec le calendrier en covariable (exploratoire), Chronos-2 y divise son erreur par deux.
- Un intervalle bien calibré n’est pas forcément utile : la référence, qui prévoit une ligne plate, couvre 0,899 des heures avec un intervalle large de 45 % de la charge.
- Sur 50 séries européennes, Chronos-2 gagne sur les 200 unités (série × longueur d’historique), surtout en démarrage à froid. Un routeur ne peut alors qu’échanger de la précision contre un coût, et le coût mesuré ne justifie pas cet échange.
- La décision de routage dérive : 40 séries sur 50 changent de branche dans l’année.
1. Le problème : un modèle par série, ou un modèle pour toutes#
La prévision de séries temporelles repose classiquement sur un modèle par série : on choisit une famille (lissage exponentiel, ARIMA, décomposition saisonnière), on l’ajuste sur l’historique et on la réajuste quand les données arrivent. J’appelle ce modèle le spécialiste : il ne connaît que sa série, mais il la connaît bien.
Un modèle de fondation est pré-entraîné une fois, sur un grand corpus de séries hétérogènes (énergie, trafic, ventes, météo, données synthétiques), pour apprendre ce qu’elles ont en commun : saisonnalités, tendances, niveaux qui bougent. À l’usage, on lui donne le passé récent d’une série nouvelle (son contexte) et il prévoit la suite sans aucun ajustement : c’est le zero-shot. Le même modèle sert tout le portefeuille.
Les deux modèles étudiés viennent de la famille Chronos d’Amazon :
- Chronos-Bolt (tailles small et base) découpe le contexte en morceaux de quelques pas et prévoit directement les 24 heures suivantes sous la forme de neuf quantiles, de 0,1 à 0,9. Il ne voit que la série.
- Chronos-2, plus récent, prévoit 21 quantiles de 0,01 à 0,99 et accepte des covariables : des séries connues dans le passé, ou connues à l’avance, comme un calendrier.
Un quantile 0,9 est la valeur sous laquelle le modèle s’attend à voir la réalité 90 % du temps. Entre les quantiles 0,05 et 0,95, on a un intervalle de prévision à 90 % : bien calibré, il contient la réalité 9 heures sur 10. C’est cette promesse, autant que l’erreur moyenne, que le plan demandait de vérifier.
2. Ce que disent les sources#
J’ai relu les trois ressources du plan à la source (articles, fiches des modèles, code publié, résultats du classement GIFT-Eval recalculés), dernière vérification le 30 octobre 2026.
| Affirmation du plan | Ce que dit la source | Verdict |
|---|---|---|
| Les trois modèles de prévision d’IBM (mars 2026) émettent des quantiles nativement | Vrai pour FlowState r1.1 (9 quantiles), TTM-r3 (nouvelle tête multi-quantiles) et PatchTST-FM r1 (99 quantiles). Seul TTM est nouveau sur ce point | tient |
| Le leader de GIFT-Eval en prévision ponctuelle ne fait que 18,5 M de paramètres | Le 12 avril 2026, FlowState r1.1 était premier au MASE seulement avec les filtres « zero-shot » et « code de réplication » ; sans filtre, 13ᵉ. Le 30 octobre 2026, il est 13ᵉ même filtré | en partie, et daté |
| Le routeur de complexité (arXiv:2605.24381) donne une meilleure précision pour un coût bien moindre qu’un TSFM universel | Le chiffre de tête classe les séries par leur MASE de test réalisé : un oracle. La règle déployée, dans le dépôt des auteurs, fait 0,981 contre 0,989 pour le TSFM seul, avec 33 % d’appels en moins. Le ratio de coût (1 000 pour 1) est supposé | en partie |
| Les spécialistes gagnent sur les systèmes à contraintes physiques | Le régime « énergie » du papier est ETTh1 : la température d’huile de 7 transformateurs. Aucune série de charge | ne se transpose pas |
| L’article de blog classe les limites des TSFM en contournables, non contournables et ouvertes | Publié le 24 avril 2026. Deux groupes seulement : les vrais défis (perte, contexte, biais haute fréquence, lois d’échelle, covariables) et les faux problèmes (interprétabilité, fuite de données) | en partie |
Le troisième point a orienté la suite. Le routeur de complexité du papier calcule quatre indicateurs sur l’historique de chaque série (entropie spectrale, coefficient de variation, autocorrélation saisonnière, part de tendance) ; la série va au TSFM quand au moins deux des quatre seuils sont franchis, sinon à un spécialiste.
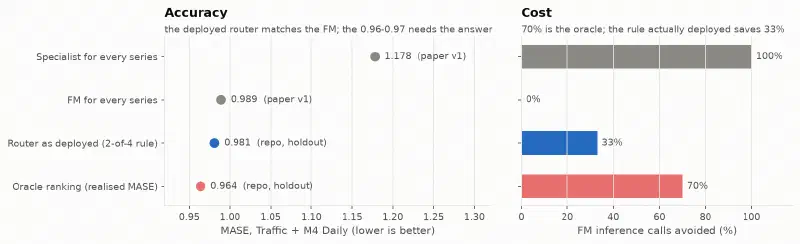
Un oracle utilise une information indisponible au moment de décider, ici l’erreur que chaque modèle fera sur le test. Il borne ce qu’un routeur parfait gagnerait, pas ce qu’un routeur réel gagne. D’où une règle pour le bloc 3 : évaluer le routeur hors échantillon dès le départ.
Deux autres vérifications. La contamination : la liste d’entraînement de Chronos-2 ne contient ni ENTSO-E ni OPSD, les sources de ma série ; celle de Chronos-Bolt n’est pas détaillée, et pourrait contenir la charge espagnole de 2015-2018 (même fournisseur, autre pays). Rien ne dit que le score de Bolt est optimiste, rien ne permet de l’exclure. Les licences : les modèles Chronos sont sous Apache-2.0 ; TTM-r3 d’IBM, sous CC-BY-NC-SA-4.0, ne peut pas entrer dans un livrable commercial.
3. La série et ses pièges#
La série est la consommation électrique nationale française, heure par heure, publiée par ENTSO-E et reprise par Open Power System Data (version du 6 octobre 2020, empreinte vérifiée).
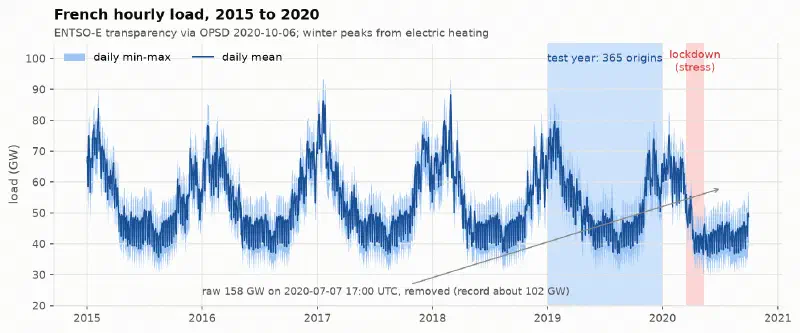
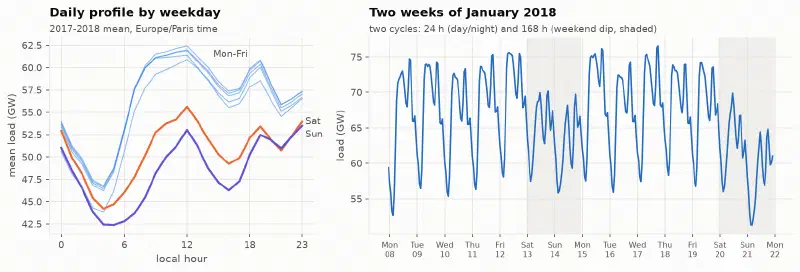
Au-delà du cycle annuel dû au chauffage, la charge superpose deux cycles : 24 heures (nuit, montée du matin, plateau, pointe du soir) et 168 heures (cinq jours ouvrés, un week-end plus bas). Un modèle qui n’a que l’un des deux se trompe de façon systématique.
Les défauts trouvés avant de modéliser#
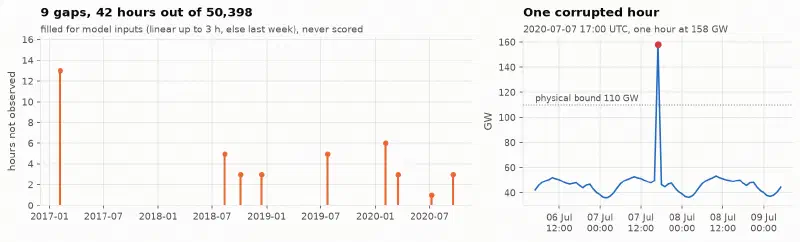
Une heure à 158 GW, pour un record national d’environ 102 GW, et neuf trous. Les valeurs hors de [20 ; 110] GW sont mises à manquant. Les trous sont comblés pour les entrées des modèles seulement (linéairement jusqu’à 3 heures, sinon par la semaine précédente), et une heure imputée n’est jamais notée : un modèle ne doit pas être récompensé pour avoir retrouvé une valeur inventée.
Deux naïfs plutôt qu’un#
Le plan demandait comme base le SeasonalNaive de saison 24 : demain est la copie d’aujourd’hui. Il prévoit donc le lundi avec le dimanche, et je m’attendais à un homme de paille. J’ai ajouté le naïf hebdomadaire (la copie de la semaine dernière). La mesure m’a donné tort.
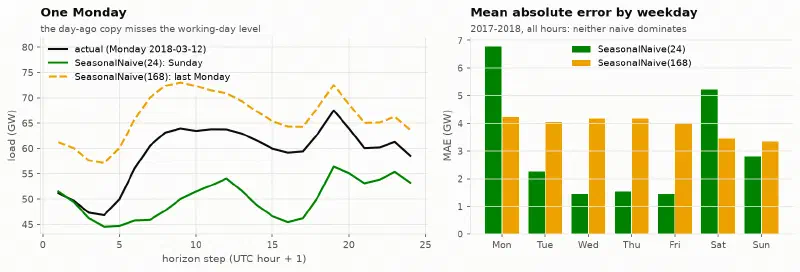
Le naïf journalier perd nettement le lundi et le samedi, les jours qui suivent un changement de régime ; les cinq autres jours, hier ressemble plus à aujourd’hui que la semaine dernière. Les deux restent dans le banc.
4. Le protocole : un backtest à origine glissante#
Le backtest à origine glissante (rolling origin) rejoue l’histoire : on se place à une date passée (l’origine), on ne donne aux modèles que les données antérieures, on prévoit les 24 heures suivantes, on compare à la réalité, puis on avance d’un jour. Le plan demandait au moins 6 origines ; j’en ai pris une par jour sur 2019, soit 365, plus une fenêtre de stress à part pendant le premier confinement (55 origines).
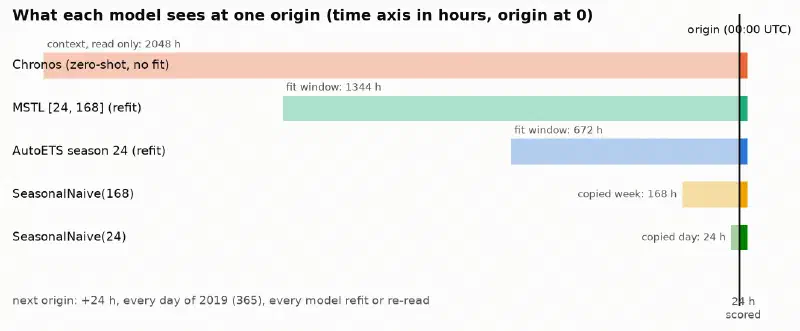
| Modèle | Ajustement | Fenêtre | Intervalles |
|---|---|---|---|
| SeasonalNaive(24), SeasonalNaive(168) | aucun | dernier jour, dernière semaine | à partir des résidus |
| AutoETS, saison 24 | réajusté à chaque origine, sélection par AICc | 672 h (4 semaines) | issus du modèle |
| ETS(Z,Z,A), saisonnalité imposée (écart déclaré) | réajusté | 672 h | issus du modèle |
| MSTL [24, 168] + tendance AutoETS | réajusté à chaque origine | 1 344 h (8 semaines) | issus du modèle |
| Chronos-Bolt small, base | zero-shot | contexte de 2 048 h | quantiles 0,1 à 0,9 |
| Chronos-2 | zero-shot, une série à la fois | contexte de 2 048 h | quantiles 0,01 à 0,99 |
ETS est la famille des lissages exponentiels : un niveau, éventuellement une tendance et une saisonnalité, mis à jour en pondérant davantage le récent ; AutoETS choisit la combinaison par un critère d’information. MSTL décompose la série en plusieurs saisonnalités (24 et 168 heures) et une tendance, prévoit chaque morceau et les recompose : c’est le seul modèle statistique du banc qui connaît les deux cycles.
Le protocole, les seuils de verdict et la règle d’incertitude ont été commités avant la première prévision. Toute valeur changée après coup est un écart, déclaré partout où il apparaît (il y en a eu un). Des tests corrompent les valeurs futures et vérifient que les prévisions ne bougent pas : aucune fuite de l’avenir.
Mesurer l’incertitude d’un écart#
« Chronos fait 15 % d’erreur en moins que MSTL » : sur une autre année, ce serait peut-être 5 % ou 25 %. Le bootstrap donne un intervalle de confiance : on retire au hasard, avec remise, des origines parmi les 365, on recalcule le ratio, 2 000 fois, et on garde les 95 % centraux. On tire des origines entières, parce que les 24 heures d’une prévision ne sont pas indépendantes, et par blocs de 7 jours consécutifs (moving block bootstrap), parce que deux jours voisins se ressemblent.
La règle de verdict pré-déclarée : le challenger gagne si l’intervalle du ratio de MASE (challenger / référence) est entièrement sous 1 et si la couverture de son intervalle à 90 % est dans la bande [0,85 ; 0,95] ; il gagne sur la précision seulement si la couverture sort de la bande ; il perd si l’intervalle du ratio est au-dessus de 1 ; sinon, on ne conclut pas.
5. Mesurer une prévision : le MASE et ses alternatives#
Le quatrième bloc du plan était une lecture, Hyndman et Koehler (2006), Another look at measures of forecast accuracy, qui a introduit le MASE. Je la place ici parce que tout ce qui suit en dépend.
L’erreur absolue moyenne (MAE) s’exprime en mégawatts : on ne peut pas la moyenner entre l’Allemagne et la Lettonie. Le MASE divise l’erreur par celle d’une méthode naïve sur l’historique de la même série :
$$ \text{MASE} = \frac{\dfrac{1}{H}\sum_{h=1}^{H} \lvert y_{T+h} - \hat y_{T+h} \rvert} {\dfrac{1}{T-m}\sum_{t=m+1}^{T} \lvert y_t - y_{t-m} \rvert} $$Le numérateur est l’erreur sur les \(H = 24\) heures prévues ; le dénominateur, l’erreur moyenne qu’aurait faite sur l’historique la copie de la valeur d’il y a \(m\) heures. Avec \(m = 24\), un MASE de 0,4 veut dire « 40 % de l’erreur de la copie de la veille ». En relisant l’article, j’ai noté qu’il définit le MASE avec le naïf à un pas (\(m = 1\)) ; la version saisonnière est celle du manuel FPP3 (section 5.8), qu’il faut citer pour \(m = 24\).
Pourquoi pas le MAPE, ni le sMAPE#
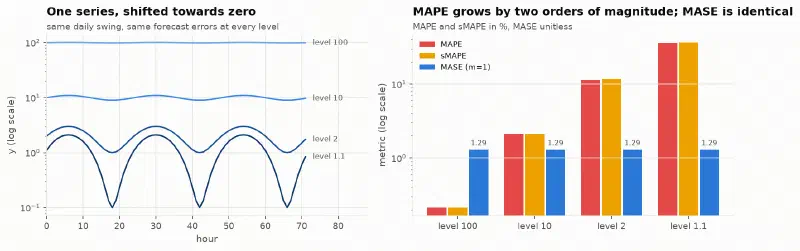
Le MAPE divise chaque erreur par la valeur observée : les mêmes erreurs donnent un MAPE cent fois plus grand près de zéro, et il n’est pas défini en zéro. Il suppose aussi un zéro qui a un sens, ce qui n’est pas le cas des degrés Celsius. Le sMAPE, dit « symétrique », divise par la moyenne de l’observé et de la prévision, et ne l’est pas.
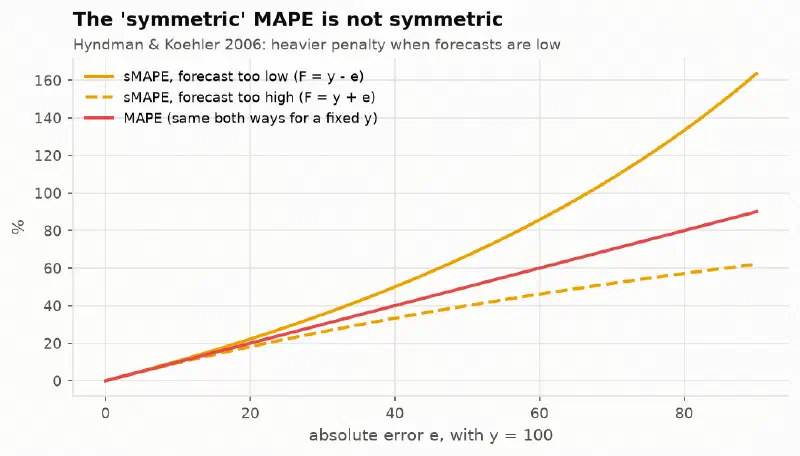
La charge française ne descend jamais sous 29 GW : le MAPE y resterait utilisable. L’argument pour
le MASE est ici la comparabilité entre séries. (La bibliothèque utilsforecast calcule un
sMAPE égal à la moitié de celui des manuels ; il ne sert à aucune décision.)
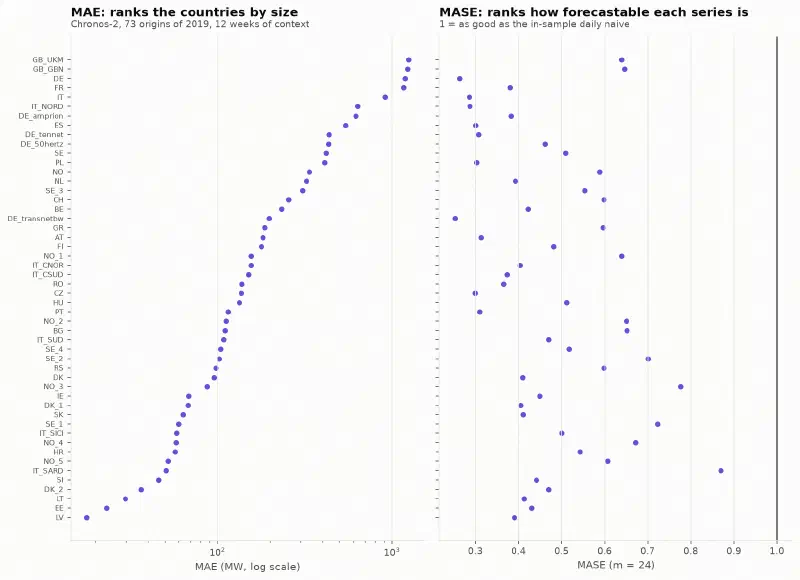
La MAE classe les pays par taille ; le MASE les classe par difficulté (la Sardaigne est la plus dure, une zone allemande la plus facile). C’est ce qui rend possible le routeur du bloc 3.
Le choix de l’échelle change le sens de « 1 »#
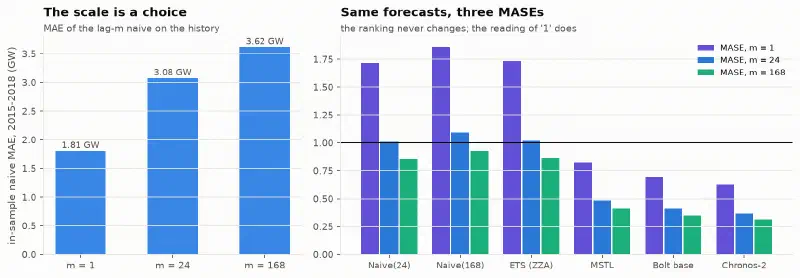
Avec \(m = 24\), le naïf journalier obtient 1,01 : il refait hors échantillon ce qui définit l’échelle. Avec \(m = 1\), les mêmes prévisions obtiennent 1,72, parce qu’on compare une prévision à 24 heures à l’erreur d’une prévision à une heure. Un MASE n’a de sens qu’avec son \(m\).
6. Mesurer un intervalle : couverture, largeur et score#
Le plan insistait : « si le TSFM gagne en MASE mais que sa couverture réelle à 90 % est de 70 %, tu dois savoir le dire ». Quatre mesures servent pour les intervalles :
- la couverture, part des heures où la réalité tombe dans l’intervalle (0,90 visé à 90 %) ;
- la largeur moyenne, en part de la charge ;
- le score de Winkler, qui combine les deux pour un intervalle \([l, u]\) à \(1-\alpha = 90\,\%\) :
On paie la largeur, plus vingt fois l’écart (\(2/\alpha = 20\)) quand la réalité tombe dehors : un intervalle étroit qui rate paie les pénalités, un intervalle immense paie sa largeur ;
- la perte quantile (pinball loss), \(\rho_\tau(y, q_\tau) = (\tau - \mathbb{1}_{y < q_\tau})(y - q_\tau)\), qui note chaque quantile : pour \(\tau = 0{,}9\), être sous la réalité coûte 0,9 par unité d’écart, être au-dessus 0,1, et la valeur qui minimise cette perte est exactement le quantile 0,9. Moyennée sur 0,1 à 0,9, elle note toute la distribution.
7. Les résultats sur l’année 2019#
Le tableau imprimé par w25 backtest, identique d’une exécution à l’autre (au bit près sur le même
GPU, à 0,016 MW près entre CPU et GPU) :
| Modèle | MASE | WAPE | cov80 | cov90 | largeur 90 | Winkler 90 | perte quantile |
|---|---|---|---|---|---|---|---|
| SeasonalNaive(24) | 1,001 | 0,059 | 0,824 | 0,879 | 0,293 | 7,08 | 0,429 |
| SeasonalNaive(168) | 1,084 | 0,061 | 0,854 | 0,915 | 0,330 | 6,92 | 0,448 |
| AutoETS | 1,715 | 0,102 | 0,772 | 0,899 | 0,450 | 8,74 | 0,669 |
| AutoETS + conforme | 1,715 | 0,102 | 0,806 | 0,908 | 0,337 | 6,34 | 0,609 |
| ETS(Z,Z,A), écart | 1,010 | 0,061 | 0,652 | 0,736 | 0,176 | 6,96 | 0,410 |
| MSTL | 0,479 | 0,028 | 0,689 | 0,779 | 0,090 | 3,49 | 0,195 |
| Chronos-Bolt small | 0,435 | 0,026 | 0,859 | 0,859 | 0,088 | 2,79 | 0,173 |
| Chronos-Bolt base | 0,406 | 0,024 | 0,858 | 0,858 | 0,082 | 2,65 | 0,162 |
| Bolt base + conforme | 0,406 | 0,024 | 0,795 | 0,902 | 0,108 | 2,72 | 0,163 |
| Chronos-2 | 0,365 | 0,021 | 0,761 | 0,862 | 0,076 | 2,37 | 0,146 |
cov80 et cov90 : couverture des intervalles nominaux à 80 et 90 %. Largeur en part de la charge. Les lignes « conforme » sont décrites à la section 8.
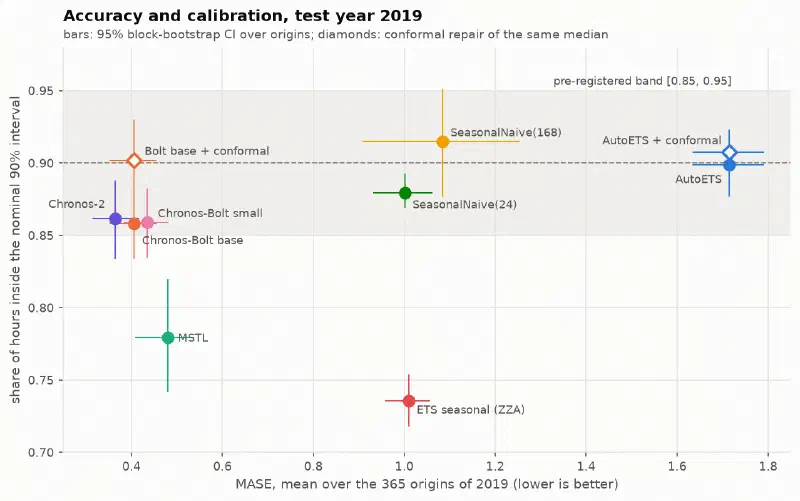
La figure se lit par coins : MSTL en bas à gauche, précis mais sous-couvert ; AutoETS en haut à droite, bien couvert mais très imprécis ; les modèles Chronos en haut à gauche, seuls à être à la fois précis et proches de la bande.
Le modèle de référence prévoit une ligne plate#
Le MASE de 1,715 d’AutoETS, pire que le naïf, m’a fait regarder ce qu’il choisissait : sur 572 des 608 origines, ETS(A,N,N), un niveau seul qui prévoit 24 fois la dernière valeur. Son critère de sélection, l’AICc, repose sur la vraisemblance des prévisions à un pas ; sur une série horaire lisse, la meilleure prévision de l’heure suivante est à peu près l’heure présente, et le niveau seul gagne ce concours. À 24 pas, il ne sait plus rien du cycle journalier.
Le verdict pré-déclaré reste rapporté (« Bolt base fait quatre fois moins d’erreur »), mais il dit peu. J’ai ajouté, en écart déclaré, un ETS à saisonnalité imposée, ETS(Z,Z,A), au niveau du naïf journalier (1,010). Même contre lui, Bolt base fait 2,5 fois moins d’erreur. Le vrai concurrent reste MSTL.
Une ligne plate peut être « parfaitement calibrée »#
AutoETS couvre 0,899 des heures, presque exactement le nominal, avec un intervalle large de 45 % de la charge : de 30 à 60 GW pour une journée d’été. Son score de Winkler, 8,74, est le pire du tableau. La couverture seule récompense un intervalle inutile.
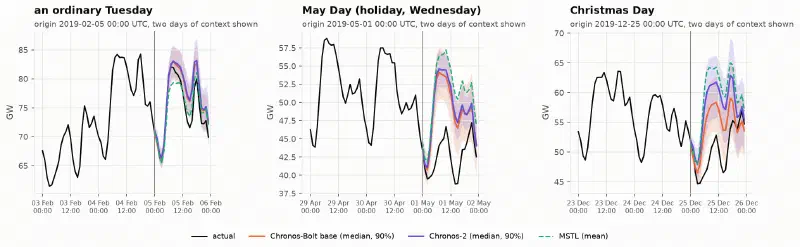
Un mardi de février, les deux TSFM ont la bonne forme de journée et leurs intervalles enveloppent la réalité. Les deux autres panneaux reviennent à la section 9.
8. L’intervalle à 90 % de Chronos-Bolt#
Dans le tableau, Chronos-Bolt a la même couverture à 80 % et à 90 % : 0,858.
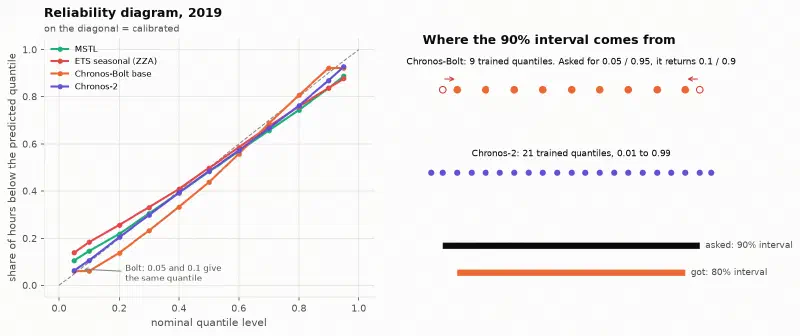
Entraîné sur les quantiles 0,1 à 0,9, Chronos-Bolt renvoie 0,1 et 0,9 quand on lui demande 0,05 et 0,95 (un test du dépôt le vérifie sur les vrais poids). Son « intervalle à 90 % » est son intervalle à 80 %. J’avais repéré ce point en lisant le code avant de lancer quoi que ce soit.
Il tombe pourtant dans la bande [0,85 ; 0,95], parce que son intervalle à 80 % sur-couvre, et l’intervalle de confiance de cette couverture (0,833 à 0,884) déborde sous la bande. La règle dit « gagne » ; je ne signerais pas un intervalle à 90 % sur cette base. Chronos-2, entraîné de 0,01 à 0,99, a un vrai intervalle à 90 % (0,862), mais sous-couvre à 80 % (0,761).
La réparation conforme#
Plutôt que de faire confiance aux quantiles d’un modèle, la prédiction conforme les reconstruit à partir de ses erreurs passées. La version utilisée ici :
- garder la médiane du modèle comme prévision ponctuelle ;
- pour chaque pas d’horizon \(h\), rassembler les erreurs absolues \(\lvert y - \text{médiane} \rvert\) du modèle au même pas sur les 56 origines précédentes, toutes observées au moment de prévoir ;
- pour un intervalle à 90 %, ajouter et retrancher à la médiane le quantile à 90 % de ces erreurs (avec la correction d’échantillon fini de la méthode).
Si les erreurs futures ressemblent aux erreurs passées, la réalité tombe dans l’intervalle 90 % du temps, quel que soit le modèle. Pour Bolt base, la couverture passe de 0,858 à 0,902, avec un intervalle un peu plus large (0,108 au lieu de 0,082). Je l’ai appliquée aussi à AutoETS, pour que la réparation ne favorise pas un seul camp. Sa limite : elle calibre en moyenne sur les 56 jours précédents, pas sur un régime rare.
9. Par horizon et par régime#
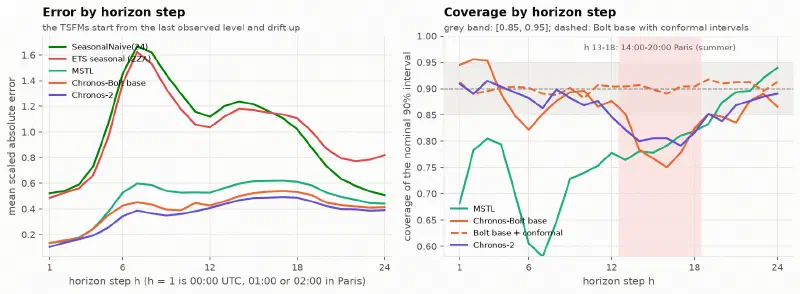
Au premier pas, tous les modèles qui lisent la dernière heure font bien : Bolt base égale MSTL, Chronos-2 en fait 77 %. L’écart s’ouvre à partir du pas 7, la montée du matin, où les naïfs et l’ETS saisonnier se trompent le plus. La couverture des TSFM descend à 0,79-0,81 sur les pas 13 à 18, l’après-midi et la montée du soir ; celle de MSTL s’effondre sur la montée du matin (0,58 au pas 7). La réparation conforme, calculée pas par pas, aplatit le profil autour de 0,90.
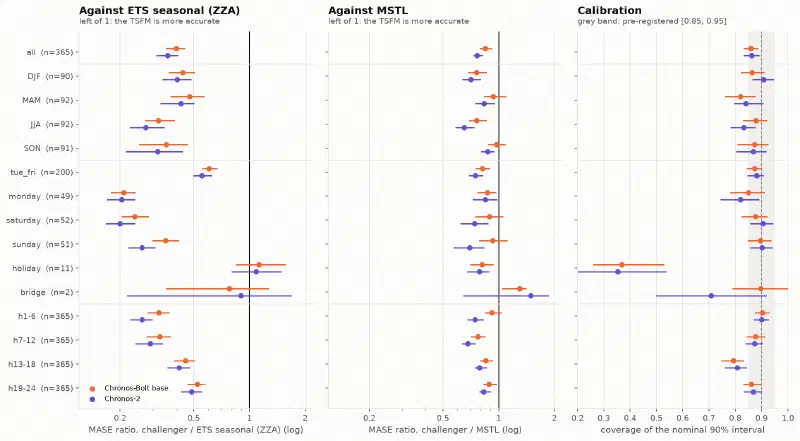
Ce forest plot résume le banc. Contre l’ETS saisonnier, les deux TSFM sont à gauche de 1 sur tous les régimes sauf les fériés et les ponts. Contre MSTL, ils sont plus près de 1, et quelques intervalles le touchent (le dimanche, le printemps et l’automne pour Bolt base). La couverture reste dans la bande ou à son bord, sauf une ligne : les jours fériés.
Les panneaux du 1er mai et de Noël, plus haut, montrent pourquoi. Un férié ressemble à un dimanche, mais rien dans les heures précédentes ne l’annonce à un TSFM univarié. Les deux tombent un mercredi : il prévoit un mercredi ordinaire, trop haut de plusieurs gigawatts, et la réalité passe sous son intervalle. Sur les 11 fériés de 2019, Bolt base a un MASE de 1,49, quatre fois son niveau ordinaire et pire que le naïf journalier (1,42). Contre l’ETS saisonnier, le ratio vaut 1,12 [0,85 ; 1,55] : pas mieux. Son intervalle à 90 % couvre 37 % des heures (Chronos-2 : 35 %, MSTL : 26 %).
Aucun modèle du banc ne reçoit d’indicateur de férié. La différence est qu’on peut en donner un à un spécialiste, alors qu’un TSFM univarié en zero-shot ne peut pas être prévenu ; Chronos-2, lui, peut l’être (section 11). Les deux ponts de 2019 ne suffisent pas : sous 10 origines, pas de verdict.
10. Trois vérifications de robustesse#
Six origines ne décident rien quand l’écart est faible#
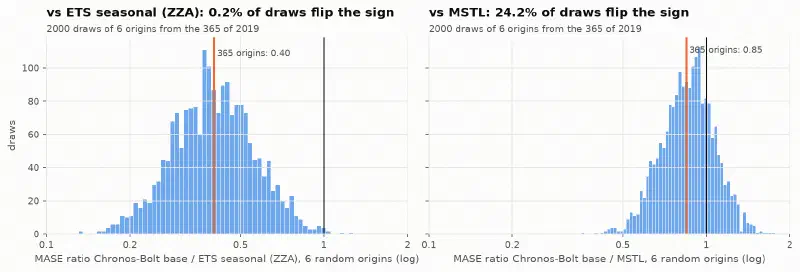
Contre l’ETS saisonnier (écart d’un facteur 2,5), presque tous les tirages de 6 origines donnent le bon classement. Contre MSTL (écart de 15 %), un sur quatre l’inverse. Six origines détectent un grand écart, pas un écart serré. Ici, les 608 origines de huit modèles prennent environ six minutes.
Le confinement#
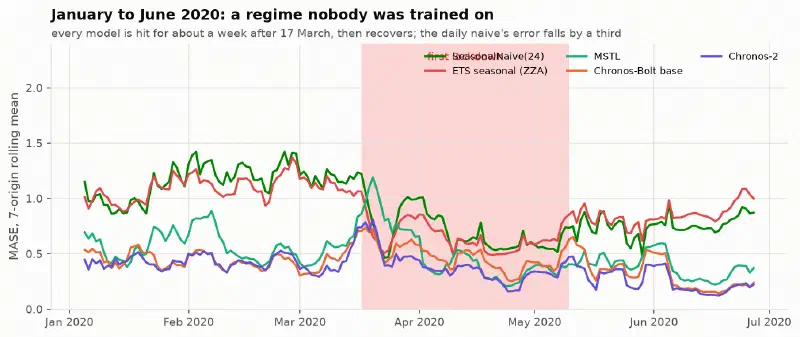
Tous les modèles sont touchés pendant environ une semaine après le 17 mars, puis se remettent. Le classement tient : Chronos-2 0,392, Bolt base 0,477, MSTL 0,506, ETS saisonnier 0,631, naïf journalier 0,672. L’erreur du naïf journalier baisse même d’un tiers : sans différence entre jours ouvrés et week-end, copier la veille devient une bonne stratégie.
La longueur de contexte (exploratoire)#
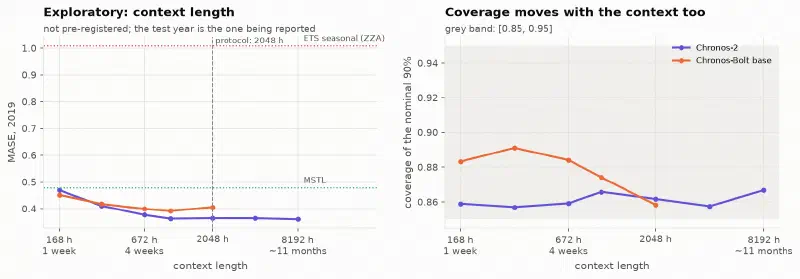
Explorée après les résultats, donc hors protocole. Avec une seule semaine de contexte, Bolt base (0,452) fait déjà mieux que MSTL ajusté sur 8 semaines (0,479). Son meilleur contexte est 1 024 heures (0,392), pas les 2 048 du protocole (0,406) ; je n’ai pas changé le protocole, ce choix serait fait sur l’année de test. Le résultat annonce le bloc 3 : un TSFM a besoin de bien moins d’historique qu’un spécialiste.
11. Donner le calendrier au TSFM#
Chronos-2 accepte des covariables connues à l’avance, dont les fériés et les ponts. Pour chaque heure, deux indicateurs 0/1 (férié, pont) sont passés au modèle sur le contexte et sur l’horizon. Même modèle, même contexte, aucun réentraînement. Cette partie est exploratoire : décidée après les résultats, sur l’année de test.
| Chronos-2, 2019 | MASE | cov80 | cov90 | perte quantile | fériés : MASE | fériés : cov90 |
|---|---|---|---|---|---|---|
| zero-shot, univarié | 0,365 | 0,761 | 0,862 | 0,146 | 1,446 | 0,352 |
| + indicateurs férié et pont | 0,331 | 0,808 | 0,899 | 0,130 | 0,745 | 0,769 |
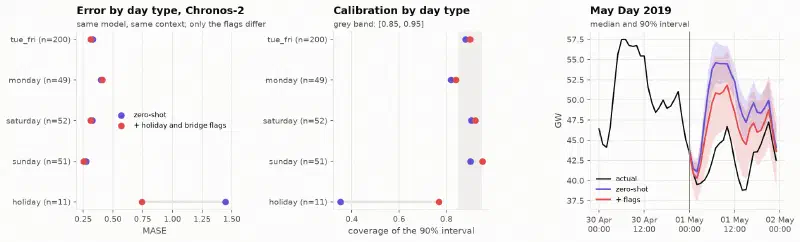
Sur les fériés, l’erreur est divisée par deux (ratio 0,52 [0,39 ; 0,67]) et la couverture passe de 0,35 à 0,77. Sur les autres jours, elle baisse un peu (ratio 0,96) : mon hypothèse, non testée, est que les fériés passés du contexte ne ressemblent plus à des anomalies une fois signalés. Sur l’année, la couverture à 90 % atteint 0,899. « Zero-shot » ne veut donc pas forcément dire « univarié ». Trouvé sur 11 jours de l’année de test, ce résultat motive un test pré-déclaré sur une autre année ; il ne le remplace pas.
12. Le routeur de complexité, reconstruit sur 50 séries#
Le troisième bloc demandait un raisonnement d’architecture, sans code, pour mettre en production le routeur du papier. Pour que chaque chiffre soit mesuré, j’ai d’abord reconstruit le routeur.
Le panel. 50 pays et zones de marché européens du paquet OPSD, avec moins de 0,5 % d’heures manquantes sur 2015-2019 ; 73 origines en 2019 (une tous les 5 jours, pour couvrir tous les jours de la semaine), horizon de 24 heures. Le démarrage à froid (cold start), une série nouvelle avec peu d’historique, est simulé en ne laissant lire que les 1, 2, 4 ou 12 dernières semaines : 200 unités (série × longueur d’historique). Le TSFM est Chronos-2 en zero-shot ; le spécialiste, MSTL [24, 168] réajusté à chaque origine (un ETS saisonnier sous deux semaines d’historique : un cycle hebdomadaire ne s’estime pas sur une semaine).
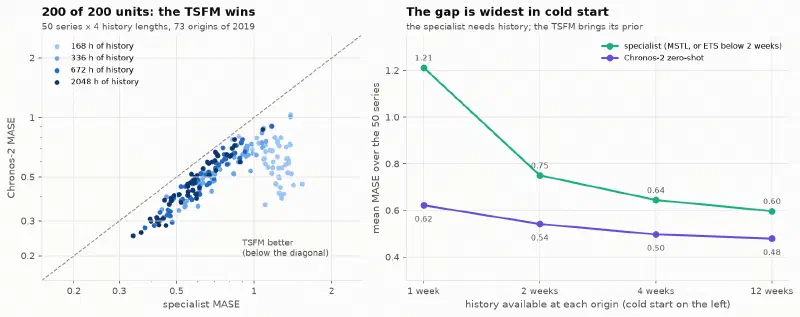
Le TSFM gagne sur les 200 unités, avec un gain de 5 % à 70 %, le plus grand en démarrage à froid : avec une semaine, le spécialiste n’a qu’un cycle hebdomadaire pour s’ajuster, le TSFM apporte ce qu’il a appris ailleurs. Sur ce point, le papier est confirmé.
Quelles caractéristiques prédisent le gain#
Un routeur décide sur des caractéristiques calculées avant la prévision (ex ante), jamais sur l’erreur future.
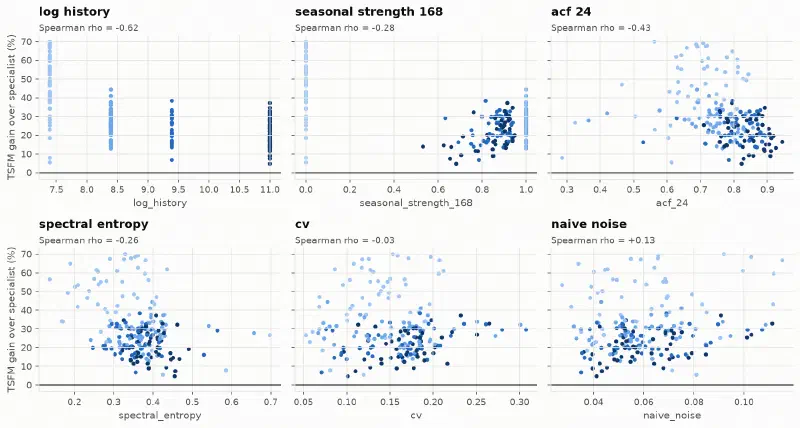
La longueur d’historique est la plus liée au gain (corrélation de rang −0,62), suivie des autocorrélations à 168 et 24 heures ; le coefficient de variation et l’entropie spectrale du papier disent peu ici. Plusieurs indicateurs bougent d’ailleurs avec la longueur d’historique elle-même. L’intermittence et les contraintes physiques, deux caractéristiques du plan, ne peuvent pas être testées : la charge nationale n’a ni l’une ni l’autre.
Les politiques pré-déclarées#
| Politique | MASE moyen | couverture 90 % | envoyé au TSFM | écart au « toujours TSFM » [IC 95 %] |
|---|---|---|---|---|
| toujours le spécialiste | 0,801 | 0,745 | 0 % | +0,266 [0,243 ; 0,296] |
| toujours le TSFM | 0,535 | 0,846 | 100 % | 0 |
| règle du papier, seuils publiés | 0,566 | 0,833 | 92 % | +0,030 [0,014 ; 0,056] |
| souche apprise, un pays laissé de côté | 0,535 | 0,846 | 100 % | 0 |
| oracle (gagnant de chaque unité) | 0,535 | 0,846 | 100 % | 0 |
La souche de décision (decision stump) est l’arbre le plus simple : une caractéristique, un seuil. Ses seuils sont appris sur les autres pays et appliqués à celui laissé de côté, pour qu’aucun pays ne note une règle qu’il a servi à construire. Sur les 28 plis, elle ne trouve aucun seuil qui améliore « toujours le TSFM », et l’oracle se confond avec lui. La règle du papier, avec ses seuils réglés sur Traffic et M4 Daily, envoie 8 % des séries au spécialiste et perd 0,030 de MASE hors échantillon.
Ce que le routeur peut encore acheter : du coût#
Si le TSFM gagne partout, un routeur ne peut plus qu’économiser des appels au TSFM, au prix de la précision. J’ai ajouté, hors protocole, une souche qui paie une pénalité par série envoyée au TSFM, avec une pénalité variable.
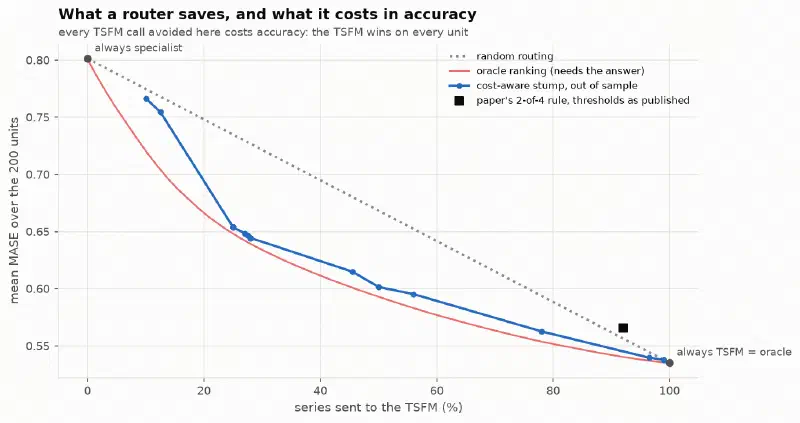
La souche reste à moins de 0,015 de MASE de l’oracle entre 25 % et 100 % d’appels au TSFM. Économiser 22 % des appels coûte 5 % de MASE, 44 % en coûtent 11 %. La règle du papier se place au-dessus de la droite du hasard : sur ce panel, elle route moins bien qu’un tirage au sort.
L’économie vaut-elle quelque chose ? Le papier suppose qu’un appel au TSFM coûte mille appels au spécialiste. Mesuré : Chronos-2 prend environ 95 ms par série sur 4 cœurs CPU (environ 5 ms en lot sur GPU), un réajustement de MSTL 183 ms sur un cœur. L’hypothèse vaut pour un spécialiste qui ne fait que prédire, pas pour un spécialiste réajusté à chaque prévision. Les millisecondes viennent d’une seule machine ; c’est le ratio qui se transpose.
13. La décision de routage dérive#
Le plan désignait un « piège senior » : la décision d’un routeur peut dériver comme celle d’un modèle. Pour le mesurer, j’ai pris une souche sensible au coût réglée pour envoyer environ deux tiers des séries au TSFM (le point de fonctionnement du routeur déployé du papier), avec une règle sur l’autocorrélation à 24 heures, réévaluée à chaque origine sur les quatre dernières semaines.
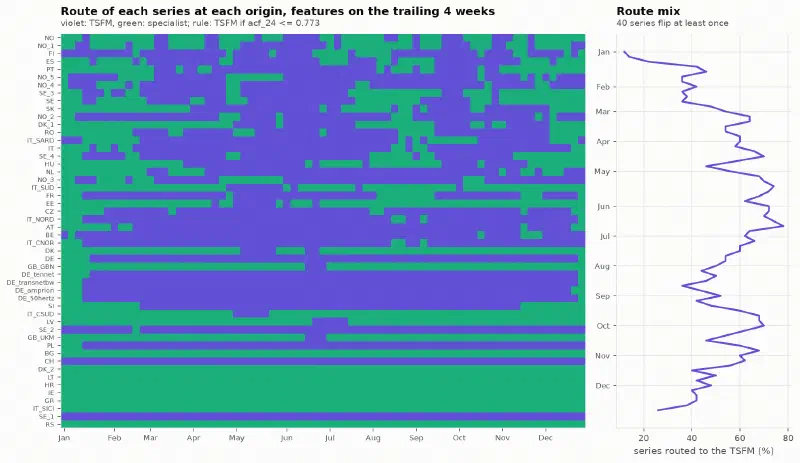
40 séries sur 50 changent de branche au moins une fois, pour 323 bascules, et la part envoyée au TSFM oscille entre 12 % et 78 %. Les bascules suivent les fériés et les saisons : les zones allemandes changent ensemble au tournant de l’année, les séries britanniques et danoises en juin. Chaque bascule change du jour au lendemain le modèle qui produit la prévision d’une série. Une bande d’hystérésis (ne changer de branche que si l’indicateur dépasse le seuil d’une marge donnée) réduit ces allers-retours :
| Bande sur l’autocorrélation à 24 h | bascules en 2019 | séries qui basculent | maximum pour une série |
|---|---|---|---|
| aucune | 323 | 40 | 22 |
| ± 0,01 | 218 | 38 | 16 |
| ± 0,02 | 168 | 38 | 16 |
| ± 0,05 | 78 | 35 | 6 |
Une autre leçon est venue d’une erreur : ma première version ajustait la souche sur des indicateurs calculés sur 2 048 heures et l’appliquait à des indicateurs calculés sur 672 heures. L’entropie spectrale dépend de la fenêtre, et la souche envoyait 4 à 20 % des séries au TSFM au lieu d’environ 56 %. C’est le décalage entre entraînement et service, version routeur.
Le raisonnement d’architecture#
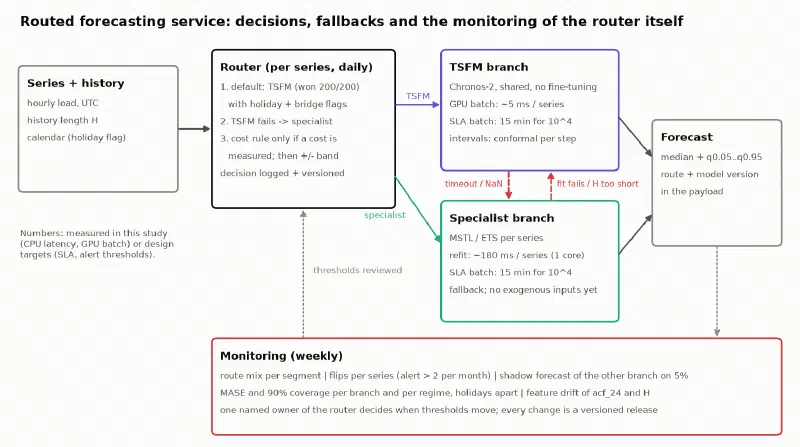
Le livrable demandé tenait en 8 à 12 lignes. Avec les mesures précédentes :
- La longueur d’historique prédit l’ampleur du gain du TSFM, pas le gagnant. Aucun seuil ne se justifie sur la précision ; le plan disait que c’est le signe d’une caractéristique de routage mal choisie, ou ici d’une absence de route à choisir.
- Par défaut, le TSFM pour toutes les séries, avec le calendrier en covariable, plutôt qu’un changement de branche les jours fériés.
- Le spécialiste comme repli : délai dépassé ou valeur manquante côté TSFM ; l’inverse si l’ajustement échoue ou si l’historique fait moins de deux jours ; le naïf journalier, signalé, si les deux échouent.
- Les deux branches en lot quotidien ; le temps réel seulement pour les re-prévisions infra-journalières, sur le TSFM, qui n’a rien à réajuster.
- Chaque prévision porte sa route et la version du modèle.
- Le routeur est suivi comme un modèle : répartition des routes, bascules par série (alerte au-delà de deux par mois), hystérésis, prévision fantôme de l’autre branche sur 5 % des séries.
- Un responsable nommé décide des seuils ; tout changement est une version évaluée hors échantillon.
- Pas de routeur de complexité dont le seul gain serait un coût que la mesure ne montre pas.
14. Ce que j’en retiens#
Ces constats valent pour des séries de charge horaires, sans température, face à des spécialistes statistiques univariés.
- Un TSFM zero-shot peut battre un spécialiste réajusté sur une série qu’il n’a jamais vue, et l’écart dépend surtout du spécialiste : un facteur 4 contre une ligne plate, 15 % contre MSTL.
- La référence mérite d’être regardée avant d’être battue : le critère à un pas d’AutoETS ne correspond pas à un horizon de 24 heures.
- La couverture ne se lit qu’avec la largeur : la ligne plate est le modèle le mieux calibré et le moins utile du tableau.
- Un intervalle se vérifie à la source : celui de Bolt à 90 % est son intervalle à 80 %, et la réparation conforme le corrige en moyenne, pas sur les régimes rares.
- Le calendrier est la faiblesse du zero-shot univarié, et une covariable la corrige sans réentraînement.
- Le démarrage à froid est le cas où l’écart est le plus grand : deux fois moins d’erreur avec une semaine d’historique.
- Un routeur ne vaut que l’écart qu’il exploite, et ici aucun ne favorise le spécialiste.
- La décision de routage dérive et demande le même suivi qu’un modèle.
Limites et questions ouvertes. Une seule série pour le bloc 2 et pas de température, facteur de premier ordre pour la charge nationale. Les spécialistes sont univariés : un spécialiste avec un indicateur de férié est le prochain test, le plus susceptible d’inverser des unités. Les origines sont à minuit UTC, alors qu’une prévision pour le marché du lendemain est émise vers midi la veille. L’effet du calendrier sur Chronos-2 reste à confirmer sur une autre année, protocole déclaré avant.
Reproduire et aller plus loin#
Le code, les tests et les résultats sont dans le dépôt
gwils28/W25_tsfm_viability (Python 3.11, versions
verrouillées par uv) ; make all refait tout, des données au rapport, GPU optionnel. Les
décisions prises avant d’écrire du code sont dans SPEC.md, les écarts et corrections dans
IMPLEMENTATION_NOTES.md, dont une relecture indépendante qui a corrigé le bootstrap sur les
régimes rares. Le rapport en ligne reprend les
figures dans leur ordre d’origine.
La suite est un cas client : la fiche Modèles de fondation pour séries temporelles : prévoir la consommation électrique du lendemain de 3 517 bâtiments tertiaires repose la question avec la météo et le calendrier en covariables, la prévision J-1 de RTE comme benchmark et un coût en euros. Contre un LightGBM qui reçoit ces covariables, Chronos-2 ne gagne plus partout, et le mélange des deux fait mieux que tout routeur.
Sources
- Soni, Das et Guduguntla, Assessing the operational viability of foundation models for time series forecasting, arXiv, mai 2026, et le code des auteurs.
- Ansari et al., Chronos: Learning the language of time series, 2024 ; le rapport technique de Chronos-2, 2025 ; la fiche de Chronos-Bolt base.
- TSFM.ai, IBM’s March 2026 time-series refresh, avril 2026.
- Kafritsas, Time series foundation models: a deep dive into strengths and limitations, AI Horizon Forecast, avril 2026.
- Hyndman et Koehler, Another look at measures of forecast accuracy, International Journal of Forecasting, 22(4), 2006 ; Hyndman et Athanasopoulos, Forecasting: Principles and Practice, 3ᵉ édition, section 5.8.
- Open Power System Data, paquet de séries temporelles, version du 6 octobre 2020.