1,07e-5
écart à la bibliothèque
+2,3 %
MASE régional
356
origines backtestées
Note de transparence. Ces travaux ont été menés à titre personnel, dans un but d’apprentissage, avec l’assistance d’une IA :
- pour le code, la relecture technique et méthodologique ;
- pour comprendre les outils et les méthodes mathématiques ;
- pour l’aide à la rédaction, la traduction et la correction du texte ;
- pour générer l’image de couverture de cette fiche.
Le choix du sujet, le protocole, la vérification des résultats et les conclusions sont les miens, et j’en assume les erreurs. Comment j’utilise l’IA
Ce dépôt est le laboratoire de l’article La réconciliation hiérarchique en forecasting : promesses et limites. L’article raconte ce que j’en ai tiré ; cette fiche montre comment le travail est organisé et comment le reproduire.
L’objectif#
Des prévisions produites série par série ne somment pas : la somme des régions ne donne pas le total national, et quelqu’un doit trancher. La réconciliation (MinT en tête) promet de supprimer cet arbitrage. Je voulais savoir trois choses :
- écrire la projection
P = S(S'W⁻¹S)⁻¹S'W⁻¹de ma main, et retrouver la bibliothèque au chiffre près ; - identifier où MinT casse : biais, quantiles, mur numérique ;
- vérifier sur de vraies données si la réconciliation améliore la précision, ou seulement la cohérence.
La démarche#
Le travail suit six blocs, un dossier chacun. Le code vit dans un seul package
(src/w37_reconciliation), les notebooks pédagogiques l’appellent, et chaque bloc a son
README (résultats) et son TUTORIEL (pour relancer).
- 1
Veille
Quatre articles de 2026 vérifiés, une synthèse en trois points et une note sur ce qui est surcoté : la réconciliation vendue comme un gain de précision. - 2
MinT de zéro
Shrinkage de Schäfer–Strimmer, projection oblique, trois assertions. Écart à HierarchicalForecast : 1,07e-5. Il ne vient pas de λ, comme le plan le supposait, mais de l’estimateur de covariance (centrage et division par T−1). - 3
System design
Un job batch matérialisé avec un contrat YAML versionné, un hash de la hiérarchie et un quality gate qui bloque la publication. - 4
Fondamentaux
MinT propage le biais d’une seule prévision à toutes les feuilles. Appliqué à des quantiles, il donne un vecteur cohérent et faux : 0,764 de couverture au lieu de 0,900. Seul un échantillonnage joint est calibré. - 5
Mini-projet éCO2mix
12 régions → France, données RTE 2013-2024, backtest à origines glissantes, puis un benchmark face au naïf et à la prévision de RTE, et trois études de confirmation. Le détail est plus bas. - 6
BayesReconPy
Sur des ventes intermittentes (M5), le MinT gaussien produit des ventes négatives ; le conditionnement bayésien n’en produit aucune, et il est le plus précis.
Le mini-projet éCO2mix#
L’objectif métier : livrer des prévisions de consommation électrique dont la somme des 12 régions reproduit exactement le total France.
Le protocole, fixé avant les résultats dans configs/eco2mix.yaml :
- pas horaire ;
- modèles de base SeasonalNaive(168) et MSTL ;
- fenêtre d’entraînement de 52 semaines, strictement antérieure à chaque origine ;
- horizon de 24 h ;
- cinq réconciliations, comparées par MASE niveau par niveau.
Le résultat principal#
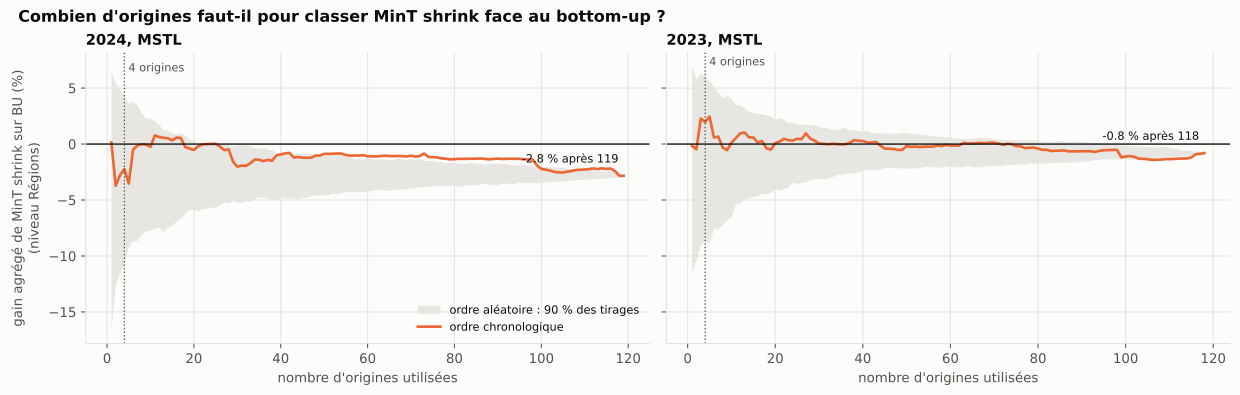
Le résultat se lit en deux temps. Sur les 4 origines du protocole principal, MinT shrink semblait gagner (−2,2 % de MASE régional). Sur 119 origines couvrant toute l’année 2024, il fait moins bien que le bottom-up, sur les 13 séries.
La cause est démontrée par une expérience contrôlée. MinT estime sa matrice W sur les résidus in-sample. Ceux de MSTL sont des restes de lissage, corrélés à 0,11 entre régions, alors que les vraies erreurs le sont à 0,56. Estimée sur les erreurs des origines passées, W ramène MinT au niveau du bottom-up (−0,1 %, non significatif).
Le benchmark : où se fait le gain#
Un résultat entre réconciliations ne dit pas ce qu’elles valent face à rien du tout. J’ai donc placé les cinq réconciliations dans un benchmark complet : quatre baselines naïves (la dernière valeur, la moyenne de 4 semaines, la même heure la semaine ou la veille), MSTL seul, et la prévision J−1 officielle de RTE. Celle-ci n’est pas un concurrent à information égale : elle utilise la météo prévue. Telle que publiée, elle sous-estime aussi la consommation d’environ 1,1 GW en permanence ; une version débiaisée lui retire son erreur moyenne des 52 semaines précédentes, sans fuite.
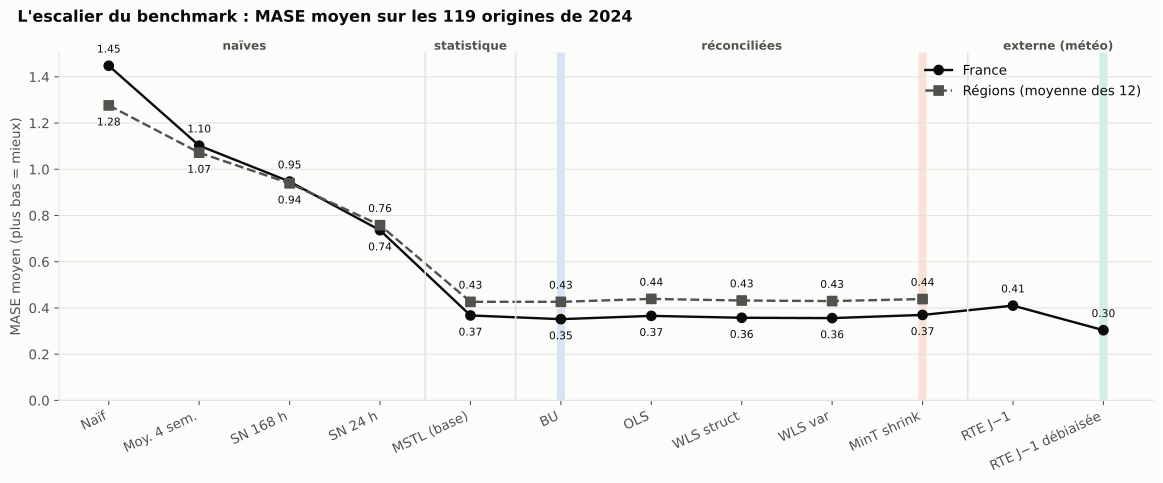
L’escalier se lit en trois marches :
- Le modèle statistique fait presque tout. MSTL divise l’erreur du naïf saisonnier par 2,6 au niveau France (61 % de gain).
- Les réconciliations forment un plateau. Leur MASE France va de 0,352 à 0,370, et le bottom-up en est le point bas, aux deux niveaux. La réconciliation déplace l’erreur de quelques pourcents ; le modèle de base l’avait déplacée de 60 %.
- Seule la météo passe sous le plateau. La prévision RTE débiaisée fait 13,6 % de mieux que le bottom-up en 2024, et 12 % en 2023.
Le classement ne dépend pas de la métrique : il est le même en MASE, en MAE (MW), en RMSE et en MAPE. Il dépend en revanche de l’heure prévue, et c’est le résultat le plus nouveau.
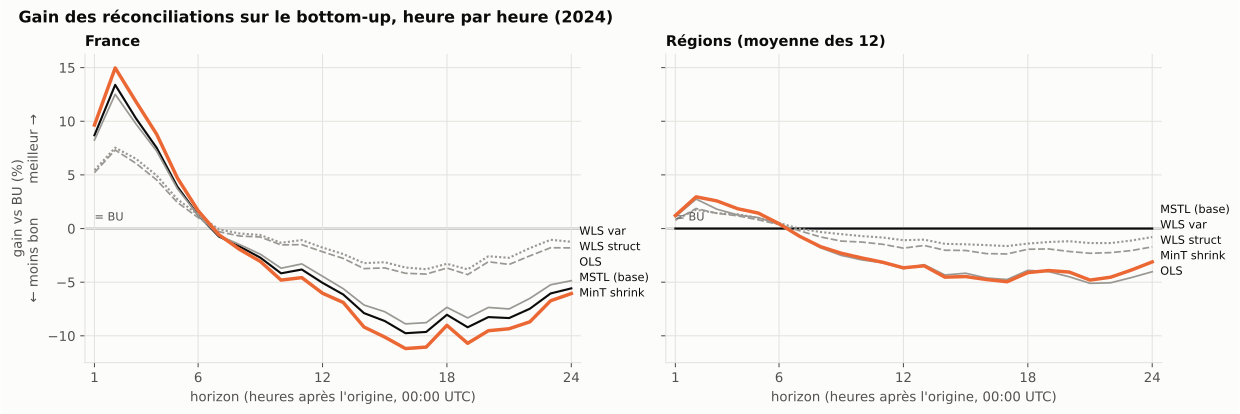
Au niveau France, la prévision MSTL directe du total et MinT shrink battent le bottom-up de 7,5 % et 8,6 % sur les heures 1 à 6 : juste après l’origine, la dernière valeur connue du total est très informative, et MinT lui donne du poids. Ensuite la prévision du total dérive, alors que la somme de 12 prévisions régionales compense une partie de leurs erreurs. Une journée compte 6 heures favorables et 18 défavorables : le bottom-up gagne en moyenne. Pour une prévision infra-journalière, la conclusion pourrait s’inverser.
Trois études de confirmation#
Ajoutées après les résultats, ces études changent une seule chose à la fois et gardent tout le reste du protocole :
- Une autre année. Sur 118 origines de 2023, l’escalier est le même et MinT shrink perd encore face au bottom-up (−0,8 % en région, −1,5 % au niveau France), mais les écarts sont trois fois plus petits et aucun n’est significatif après Holm.
- Un autre modèle de base. L’explication par W fait une prédiction testable : avec un modèle dont les résidus in-sample sont de vraies erreurs à un pas, le handicap de MinT doit disparaître. AutoETS est un filtre, qui ne regarde que le passé. Il est bien moins précis que MSTL (MASE France 0,64 contre 0,37), mais le handicap de MinT disparaît : −0,0 % en région.
- La cause, rejouée. Estimer W sur les erreurs des origines passées efface aussi le handicap en 2023 (−1,0 % → −0,3 % en région). De 3 à 99 origines passées, MinT reste à ±3 % du bottom-up : il n’y a pas de fenêtre magique, il faut seulement de vraies erreurs.
La mesure directe du mécanisme tient en un tableau :
| Modèle de base | Corrélation vue par W (in-sample) | Corrélation réelle (hors échantillon) | MinT shrink vs BU (régions) |
|---|---|---|---|
| MSTL | 0,11 à 0,13 | 0,56 | −2,8 % |
| AutoETS | 0,49 à 0,57 | 0,66 | −0,0 % |
Quand W voit des corrélations proches de la réalité, MinT ne perd plus rien. Quand elle voit des régions presque indépendantes alors qu’elles se trompent ensemble, MinT répartit mal ses corrections. Avec un bon W, il ne fait pas mieux que le bottom-up pour autant.
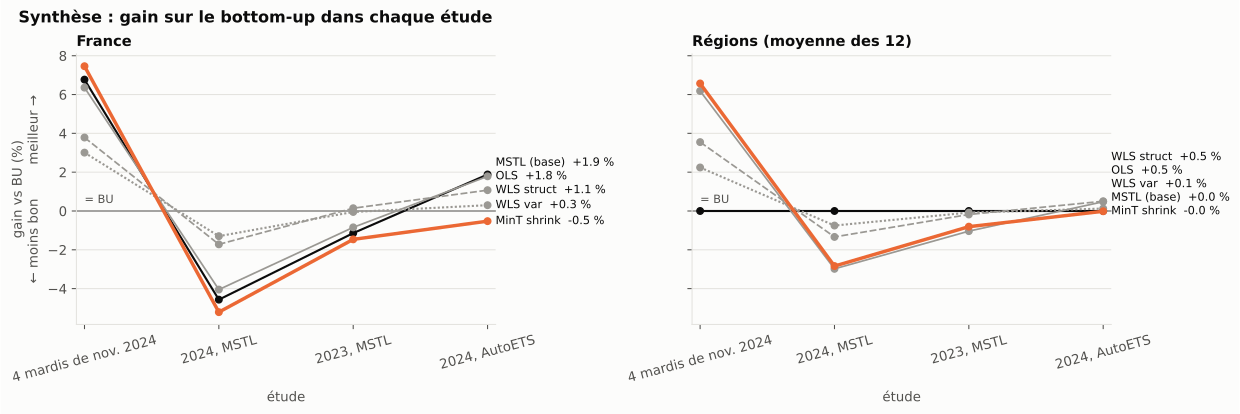
Le bilan : sur 356 origines et deux modèles de base, le bottom-up n’est jamais battu de façon significative. Ce qui s’affaiblit, c’est l’ampleur : en 2023 ou avec AutoETS, choisir entre BU, WLS et OLS ne change presque rien.
Ce qui a coincé#
- Les données avant les modèles. La Nouvelle-Aquitaine s’arrête fin 2024. La source a aussi un défaut de changement d’heure chaque année : doublons en mars, heure manquante en octobre. Une ligne absente ne lève aucune erreur, elle fausse le total en silence.
- 4 origines ne classent rien. En tirant les origines au hasard, le gain de MinT sur le bottom-up va de −10,8 % à +4,3 % avec 4 origines. Il en faut 22 en 2024, et 96 en 2023 où l’écart est plus petit, pour que tous les tirages donnent le même signe. D’où des tests appariés avec correction de Holm avant de conclure.
- Une moyenne de rapports peut mentir. Face au bottom-up, la prévision RTE débiaisée fait 13,6 % de mieux en gain agrégé, mais 51,6 % de moins bien en moyenne des gains par origine : les jours calmes, l’erreur du bottom-up est minuscule et le rapport explose. Pour comparer des méthodes très différentes, on compare des moyennes d’erreurs, pas des moyennes de rapports.
- Le λ naïf ne passe pas à l’échelle. Le tenseur
T × m × mpèse 31 Go à m = 5 000. Passer par la matrice de GramT × Tramène ce coût à 0,6 Go, pour le même résultat. - Vérifier un paquet avant de le recommander. BayesReconPy 0.5.0 ne s’installe plus tel quel (PuLP 4), et sa licence est contradictoire.
Ce que j’en retiens#
- Cohérent ne veut pas dire calibré, ni plus précis : MinT garantit la cohérence, le reste est un bonus.
- Sur une hiérarchie plate et très corrélée, le bottom-up est le choix le plus précis et le plus simple à défendre : il n’est jamais battu de façon significative, sur deux années et deux modèles de base.
- Le levier est le modèle de base et l’information qu’il reçoit : la météo vaut plus que toute réconciliation.
- Une hypothèse cachée (W in-sample) peut renverser un résultat : il faut la tester, pas la supposer. Ici, trois expériences indépendantes pointent la même cause.
- Une conclusion se confirme en changeant une seule chose à la fois : l’année, le modèle, la façon d’estimer W.
Reproduire#
git clone https://github.com/gwils28/W37_hierarchical_reconciliation
cd W37_hierarchical_reconciliation
uv sync && uv run pytest   # 100 tests : 89 unitaires, 11 de bout en bout
make eco2mix               # télécharge les données RTE, backtest, rapport
make eco2mix-robustness    # 119 origines de 2024 (≈ 40 min)
make eco2mix-confirmation  # 2023, puis AutoETS sur 2024 (≈ 25 min)
Données : Open Data Réseaux Énergies (ODRÉ) — RTE, Licence Ouverte v2.0.